跟着知乎大牛猛猿过一下相关知识
这里大部分引用知乎文章(https://zhuanlan.zhihu.com/p/613196255)的内容
流水线并行
经典的流水线并行范式有Google推出的Gpipe和微软推出的PipeDream,主要差别为,在梯度更新上,Gpipe是同步的而PipeDream是异步的。
优化目标:
- 能训练更大的模型。理想状况下,模型的大小和GPU的数量成线性关系。即GPU量提升x倍,模型大小也能提升x倍。
- 能更快地训练模型。理想状况下,训练的速度和GPU的数量成线性关系。即GPU量提升x倍,训练速度也能提升x倍。
但是难点在于GPU不仅要存模型参数,还要存中间结果。第二网络通讯存在开销。
模型并行
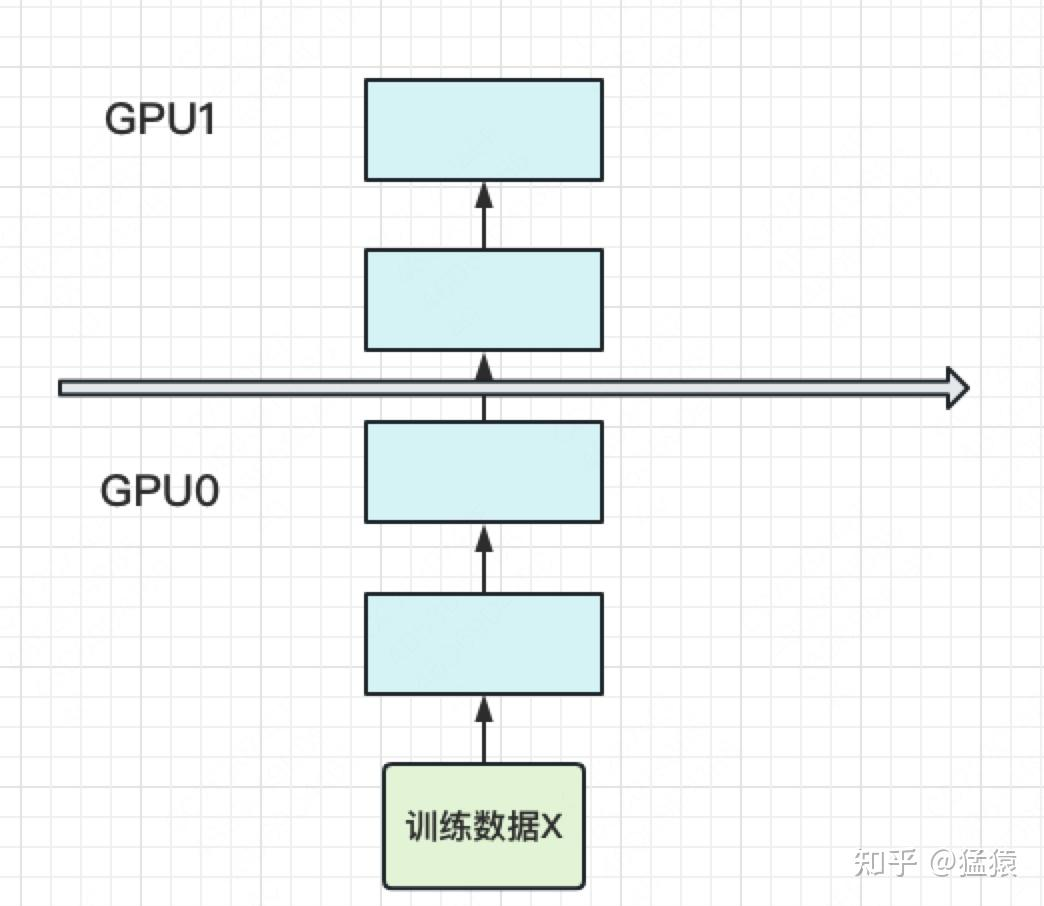
当你有一个单卡装不下的大模型时,一个直接的解决办法是,把模型隔成不同的层,每一层都放到一块GPU上,此时模型做一轮forward和backward的过程如下:
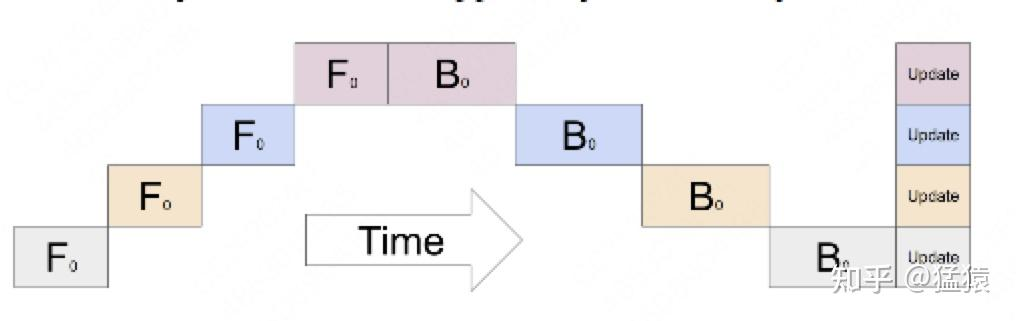
这张图的含义是:我在GPU0上做完一次forward,然后将GPU0上最后一层的输入传给GPU1,继续做forward,直到四块GPU都做完forward后,我再依次做backward。等把四块GPU上的backward全部做完后,最后一个时刻我统一更新每一层的梯度。
这里带来了两个问题:
- GPU利用度不够,GPU的数量越多时,空置的比例接近1,即GPU的资源都被浪费掉了。
- 中间结果占据大量内存,随着模型增大,可能会平滑掉GPU带来的内存收益
流水线并行
切分micro-batch
流水线并行的核心思想是:在模型并行的基础上,进一步引入数据并行的办法,即把原先的数据再划分成若干个batch,送入GPU进行训练。未划分前的数据,叫mini-batch。在mini-batch上再划分的数据,叫micro-batch。
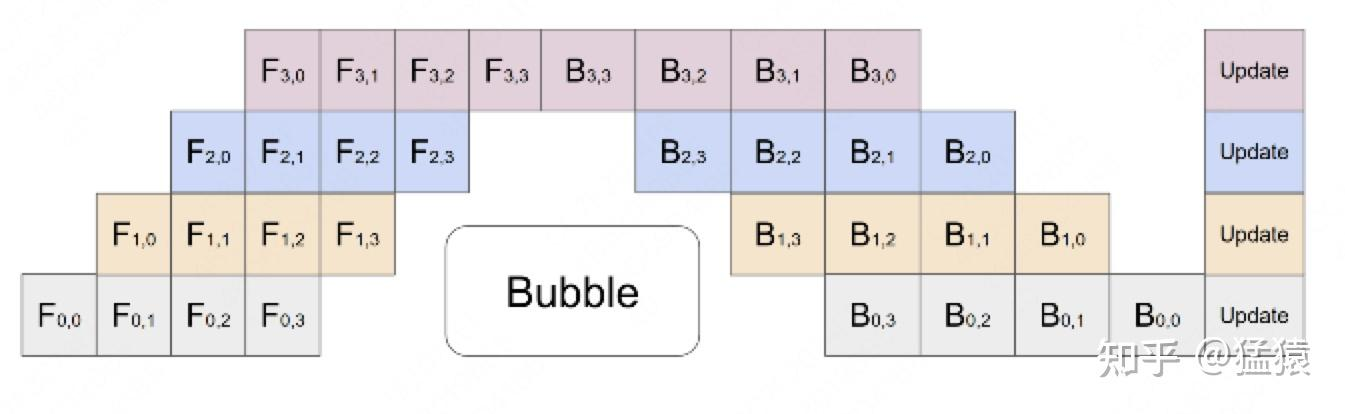
其中,第一个下标表示GPU编号,第二个下标表示micro-batch编号。假设我们将mini-batch划分为M个,则流水线并行下,bubble的时间复杂度为:$O(\frac{K-1}{K+M-1})$
(推导过程略,可参照第二部分的bubble推导流程)。Gpipe通过实验证明,当$M >= 4K$
时,bubble产生的空转时间占比对最终训练时长影响是微小的,可以忽略不计。
将batch切好,并逐一送入GPU的过程,就像一个流水生产线一样(类似于CPU里的流水线),因此也被称为Pipeline Parallelism。
re-materialization(activate checkpoint)
解决了GPU的空置问题,提升了GPU计算的整体效率。接下来,就要解决GPU的内存问题了。具体来说,就是几乎不存中间结果,等到backward的时候,再重新算一遍forward,图例如下:
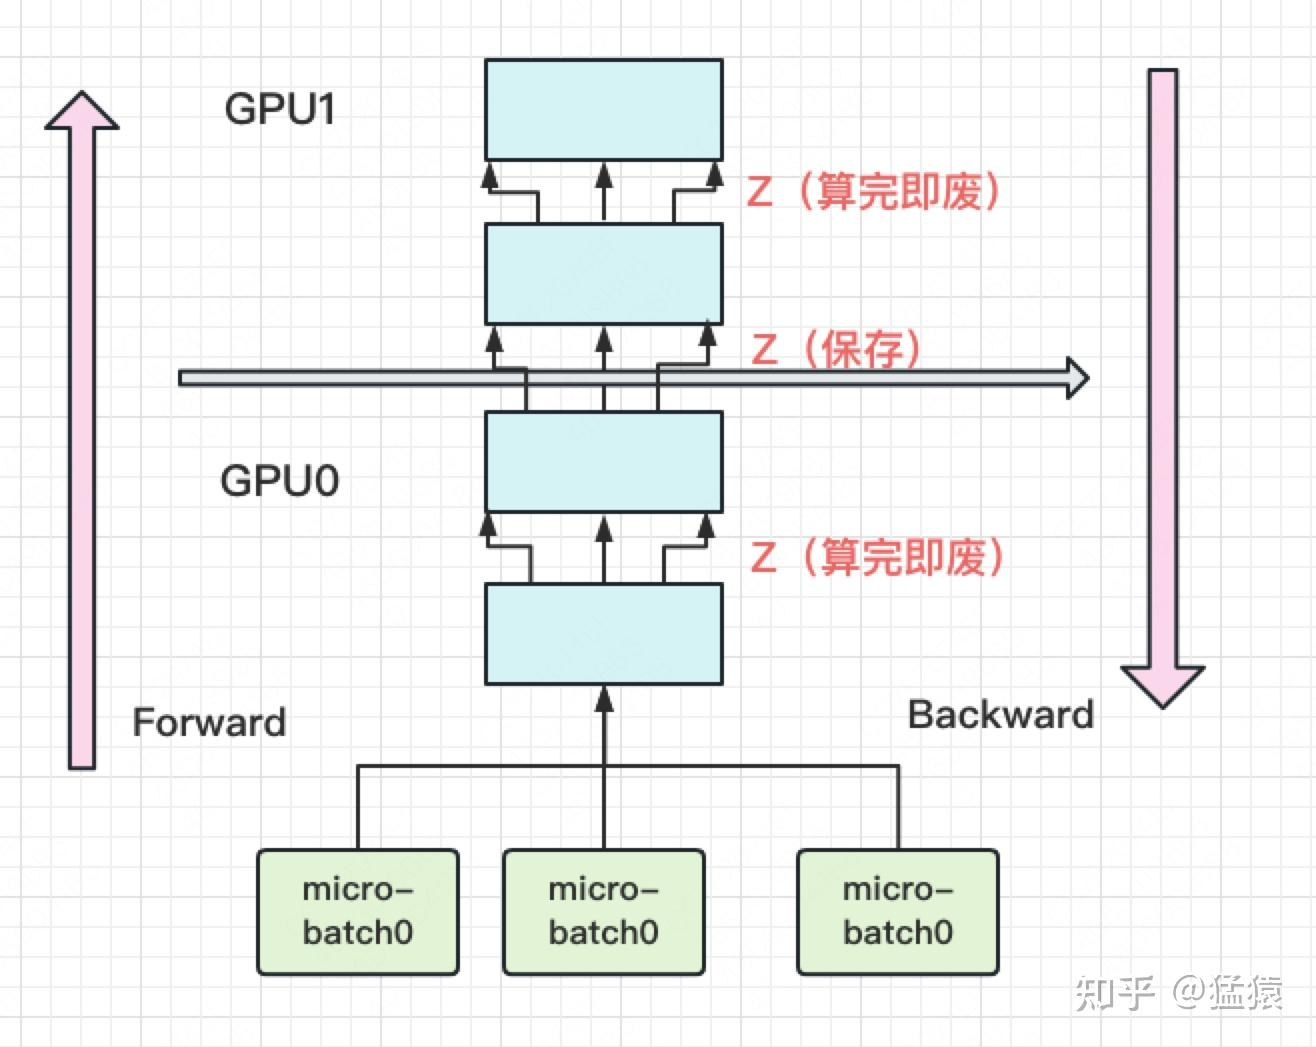
每块GPU上,我们只保存来自上一块的最后一层输入z,其余的中间结果我们算完就废。等到backward的时候再由保存下来的z重新进行forward来算出。
 现在我们来计算每块GPU峰值时刻的内存:
每块GPU峰值时刻存储大小 = 每块GPU上的输入数据大小 + 每块GPU在forward过程中的中间结果大小
每块GPU上固定需要保存它的起始输入,我们记起始输入为 $N$
(即mini-batch的大小)。
每个micro-batch是流水线形式进来的,算完一个micro-batch才算下一个。在计算一个micro-batch的过程中,我们会产生中间变量,它的大小为$\frac{N}{M}*\frac{L}{K}*d$
(其中M为micro-batch个数)。
因此,每块GPU峰值时刻的空间复杂度为 $O(N + \frac{N}{M}*\frac{L}{K}*d)$
将其与朴素模型并行中的GPU空间复杂度 O(N* \frac{L}{K}*d)
比较,可以发现,由于采用了micro-batch的方法,当L变大时,流水线并行相比于朴素模型并行,对GPU内存的压力显著减小。
最后,再提一点,在micro-batch的划分下,我们在计算Batch Normalization时会有影响。Gpipe的方法是,在训练时计算和运用的是micro-batch里的均值和方差,但同时持续追踪全部mini-batch的移动平均和方差,以便在测试阶段进行使用。Layer Normalization则不受影响。
这段话的意思是,BatchNorm的均值和方差是跨batch中的样本计算的。原本统计的是全部样本,但现在只统计micro-batch里面的均值和方差。与此同时我们维护一个全部batch的平均和方差,只在测试期间持续维护。
因此micro-batch太小时,BN效果往往会变差。这也是流水线并行、超大模型训练里BN不太方便的一个原因。
实验效果
GPU数量 VS 模型大小
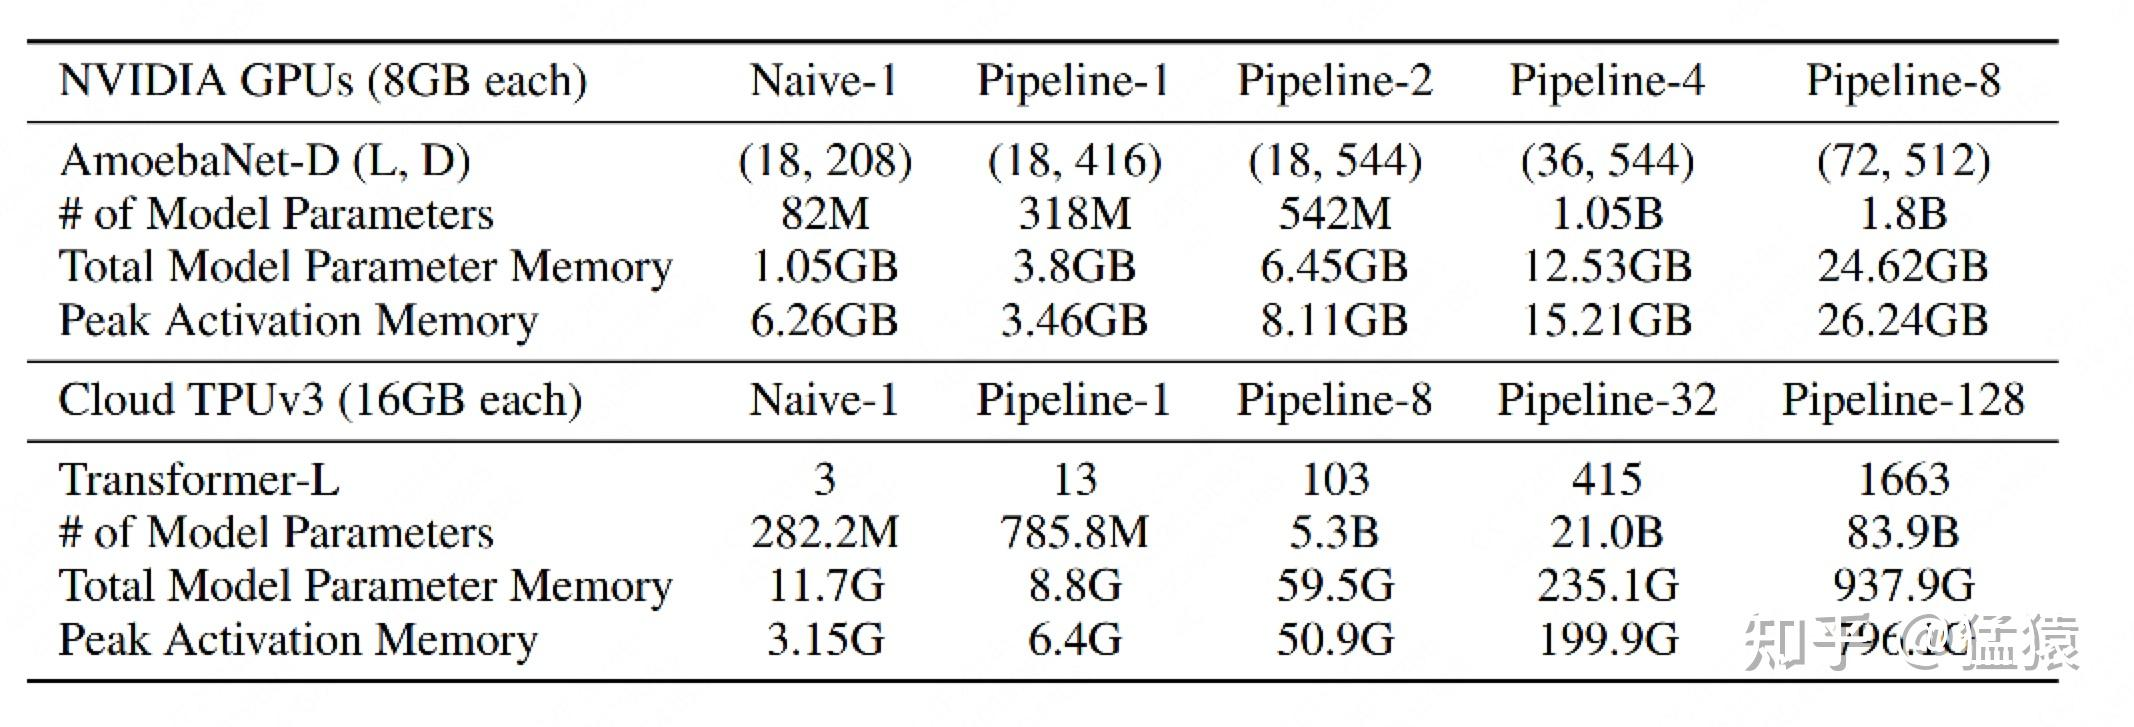
在Transformer上,Gpipe基本实现了模型大小(参数量)和GPU个数之间的线性关系。例如从32卡增到128卡时,模型的大小也从21.08B增加到82.9B,约扩4倍
对AmoebaNet而言,却没有完全实现线性增长。例如从4卡到8卡,模型大小从1.05B到1.8B,不满足2倍的关系。本质原因是AmoebaNet模型在切割时,没有办法像Transformer一样切得匀称,保证每一块GPU上的内存使用率是差不多的。因此对于AmoebaNet,当GPU个数上升时,某一块GPU可能成为木桶的短板。
这里看似没有翻倍时好事,但是这里意味着GPU有显存没有利用,有些卡存在大量碎片化的无法利用的剩余容量
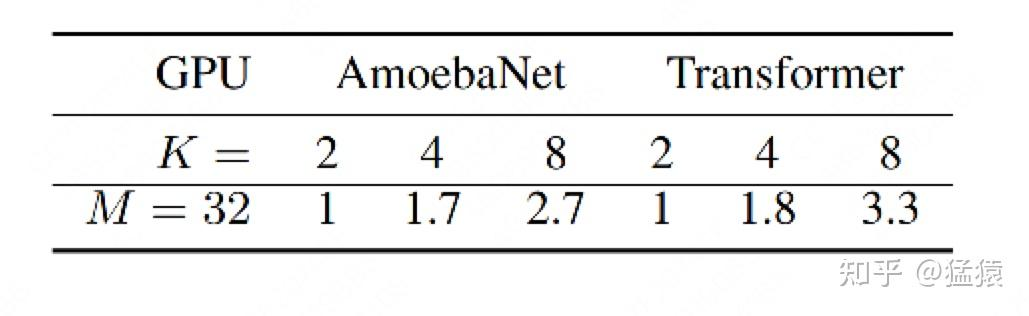
GPU数量 VS 训练速度
关掉NVlinks:
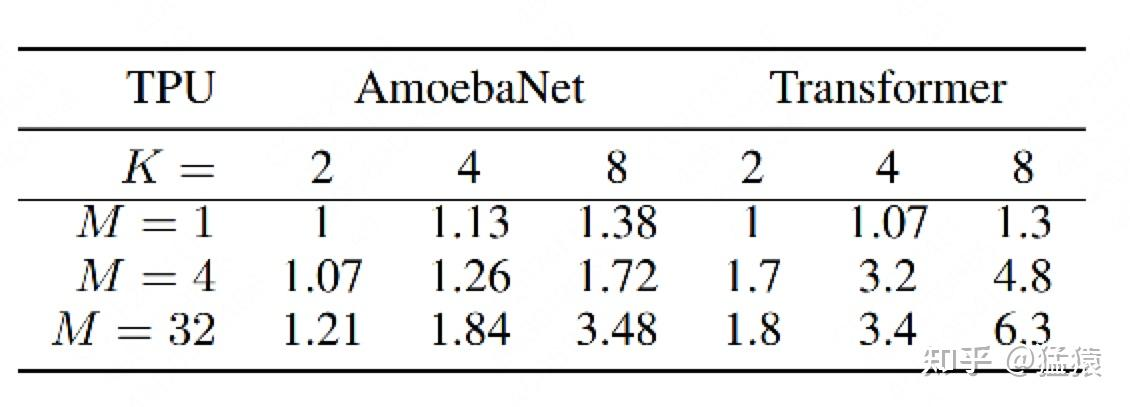
开启NVlinks,并寻找最佳M
Gpipe下的时间消耗分布
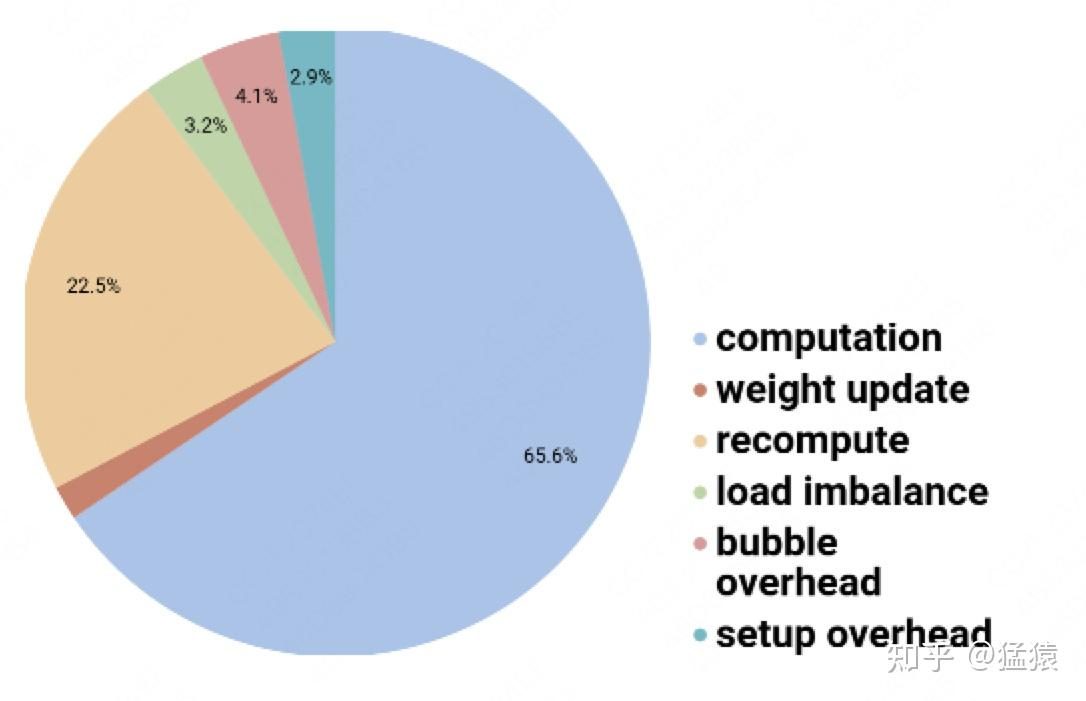
对每块GPU来说,约2/3的时间,是真正花在计算上的。
其余1/3的时间,大部分花在re-materalization策略下的重计算上。因为采用流水线的方法,bubble的时间也被压缩到很短,可以忽略不计。
数据并行(DP与DDP)
在实际应用中,流水线并行并不特别流行,主要原因是模型能否均匀切割,影响了整体计算效率,这就需要算法工程师做手调。因此,今天我们来介绍一种应用最广泛,最易于理解的并行范式:数据并行。
数据并行的核心思想是:在各个GPU上都拷贝一份完整模型,各自吃一份数据,算一份梯度,最后对梯度进行累加来更新整体模型。理念不复杂,但到了大模型场景,巨大的存储和GPU间的通讯量,就是系统设计要考虑的重点了。
文章介绍了三种主流数据并行实现方式:
- DP(Data Parallelism):最早的数据并行模式,一般采用参数服务器(Parameters Server)这一编程框架。实际中多用于单机多卡
- DDP(Distributed Data Parallelism):分布式数据并行,采用Ring AllReduce的通讯方式,实际中多用于多机场景
- ZeRO:零冗余优化器。由微软推出并应用于其DeepSpeed框架中。严格来讲ZeRO采用数据并行+张量并行的方式,旨在降低存储。
数据并行(DP)
整体架构
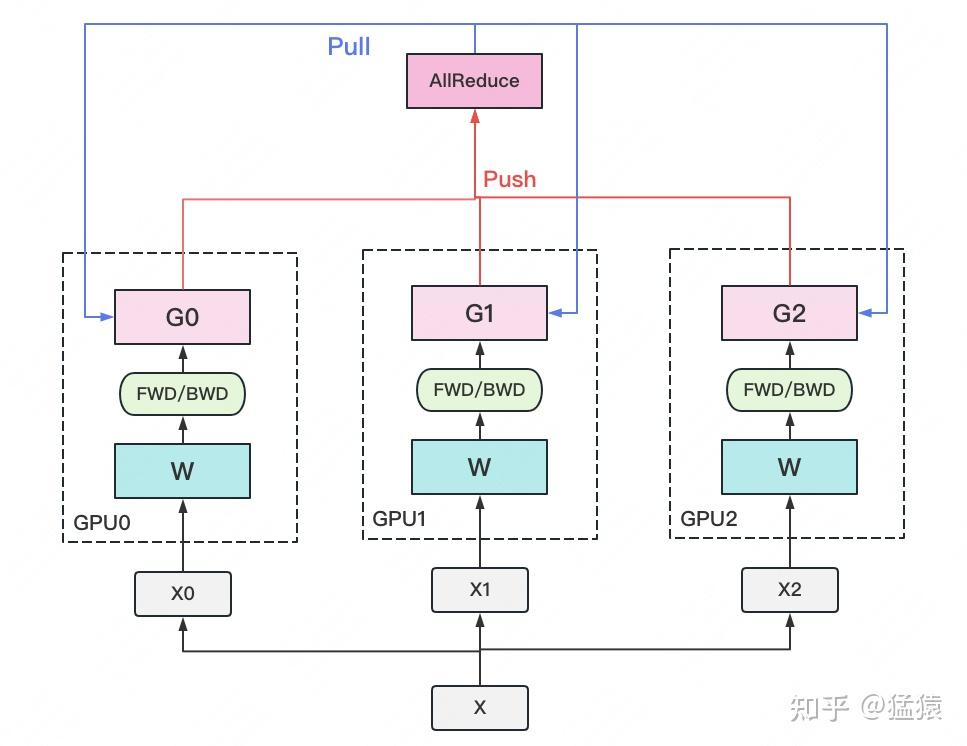
一个经典数据并行的过程如下:
- 若干块计算GPU,如图中GPU0~GPU2;1块梯度收集GPU,如图中AllReduce操作所在GPU。
- 在每块计算GPU上都拷贝一份完整的模型参数。
- 把一份数据X(例如一个batch)均匀分给不同的计算GPU。
- 每块计算GPU做一轮FWD和BWD后,算得一份梯度G。
- 每块计算GPU将自己的梯度push给梯度收集GPU,做聚合操作。这里的聚合操作一般指梯度累加。当然也支持用户自定义。
- 梯度收集GPU聚合完毕后,计算GPU从它那pull下完整的梯度结果,用于更新模型参数W。更新完毕后,计算GPU上的模型参数依然保持一致。
- 聚合再下发梯度的操作,称为AllReduce。
前文说过,实现DP的一种经典编程框架叫“参数服务器”,在这个框架里,计算GPU称为Worker,梯度聚合GPU称为Server。在实际应用中,为了尽量减少通讯量,一般可选择一个Worker同时作为Server。比如可把梯度全发到GPU0上做聚合。需要再额外说明几点:
1个Worker或者Server下可以不止1块GPU。
Server可以只做梯度聚合,也可以梯度聚合+全量参数更新一起做
在参数服务器的语言体系下,DP的过程又可以被描述下图:
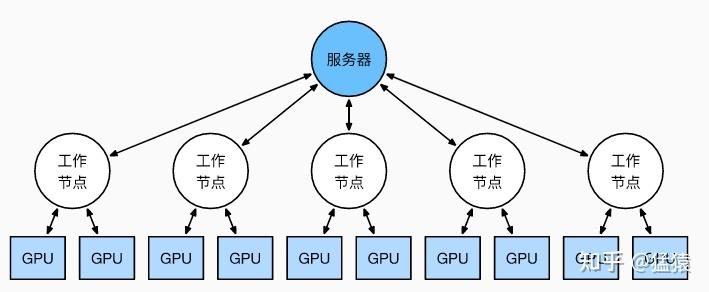
这里的运行逻辑感觉就和vLLM差不多了,后面再看vLLM的时候可以回过头来看看这个
通讯瓶颈与梯度异步更新
DP的框架理解起来不难,但实战中确有两个主要问题:
存储开销大。每块GPU上都存了一份完整的模型,造成冗余。关于这一点的优化,我们将在后文ZeRO部分做讲解。
通讯开销大。Server需要和每一个Worker进行梯度传输。当Server和Worker不在一台机器上时,Server的带宽将会成为整个系统的计算效率瓶颈。
而且Server在搬运数据和计算梯度的时候,Worker是空闲着的,在这一背景下,梯度异步更新这一管理策略诞生了:
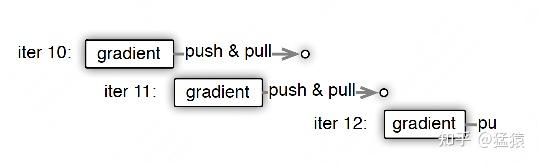
上图刻画了在梯度异步更新的场景下,某个Worker的计算顺序为:
在第10轮计算中,该Worker正常计算梯度,并向Server发送push&pull梯度请求。
但是,该Worker并不会实际等到把聚合梯度拿回来,更新完参数W后再做计算。而是直接拿旧的W,吃新的数据,继续第11轮的计算。这样就保证在通讯的时间里,Worker也在马不停蹄做计算,提升计算通讯比。
当然,异步也不能太过份。只计算梯度,不更新权重,那模型就无法收敛。图中刻画的是延迟为1的异步更新,也就是在开始第12轮对的计算时,必须保证W已经用第10、11轮的梯度做完2次更新了。
参数服务器的框架下,延迟的步数也可以由用户自己决定,下图分别刻划了几种延迟情况:
- (a) 无延迟
- (b) 延迟但不指定延迟步数。也即在迭代2时,用的可能是老权重,也可能是新权重,听天由命。
- $c$ 延迟且指定延迟步数为1。例如做迭代3时,可以不拿回迭代2的梯度,但必须保证迭代0、1的梯度都已拿回且用于参数更新。
总结一下,异步很香,但对一个Worker来说,只是等于W不变,batch的数量增加了而已,在SGD下,会减慢模型的整体收敛速度。异步的整体思想是,比起让Worker闲着,倒不如让它多吃点数据,虽然反馈延迟了,但只要它在干活在学习就行。
batch就像活,异步就像画出去的饼,且往往不指定延迟步数,每个Worker干越来越多的活,但模型却没收敛取效。
分布式数据并行(DDP)
受通讯负载不均的影响,DP一般用于单机多卡场景。因此,DDP作为一种更通用的解决方案出现了,既能多机,也能单机。DDP首先要解决的就是通讯问题:将Server上的通讯压力均衡转到各个Worker上。实现这一点后,可以进一步去Server,留Worker。
前文我们说过,聚合梯度 + 下发梯度这一轮操作,称为AllReduce。接下来我们介绍目前最通用的AllReduce方法:Ring-AllReduce。它由百度最先提出,非常有效地解决了数据并行中通讯负载不均的问题,使得DDP得以实现。
Ring-AllReduce
假设有4块GPU,每块GPU上的数据也对应被切成4份。AllReduce的最终目标,就是让每块GPU上的数据都变成箭头右边汇总的样子。
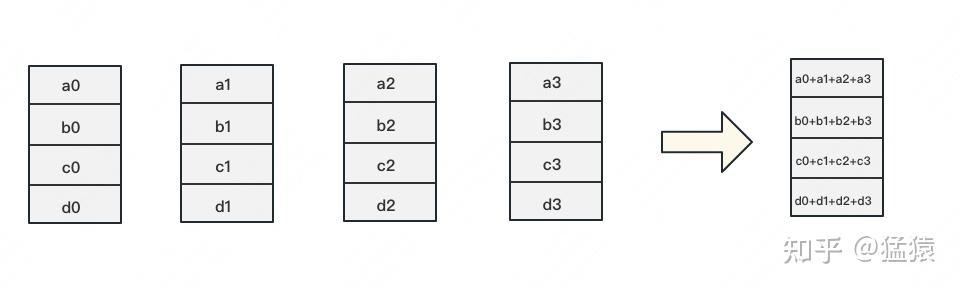
Ring-ALLReduce则分两大步骤实现该目标:Reduce-Scatter和All-Gather。
Reduce-Scatter
定义网络拓扑关系,使得每个GPU只和其相邻的两块GPU通讯。每次发送对应位置的数据进行累加。每一次累加更新都形成一个拓扑环,因此被称为Ring。
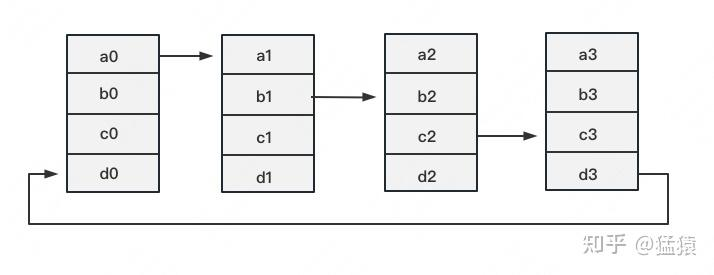
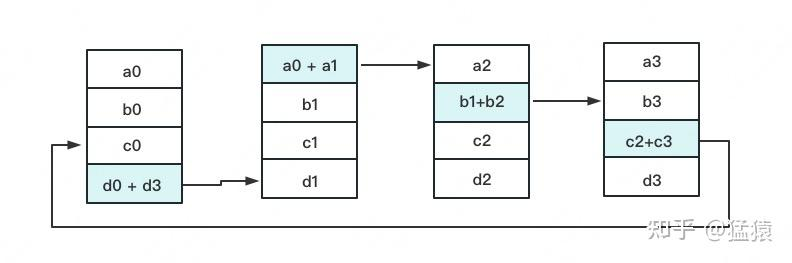
一次累加完毕后,蓝色位置的数据块被更新,被更新的数据块将成为下一次更新的起点,继续做累加操作。
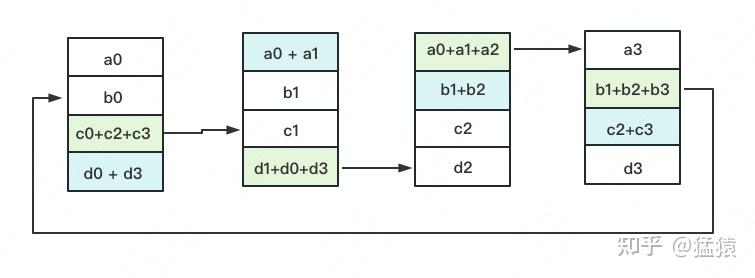
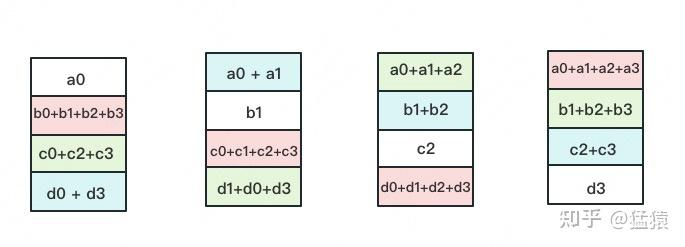
3次更新之后,每块GPU上都有一块数据拥有了对应位置完整的聚合(图中红色)。此时,Reduce-Scatter阶段结束。进入All-Gather阶段。目标是把红色块的数据广播到其余GPU对应的位置上。
All-Gather
如名字里Gather所述的一样,这操作里依然按照“相邻GPU对应位置进行通讯”的原则,但对应位置数据不再做相加,而是直接替换。All-Gather以红色块作为起点。
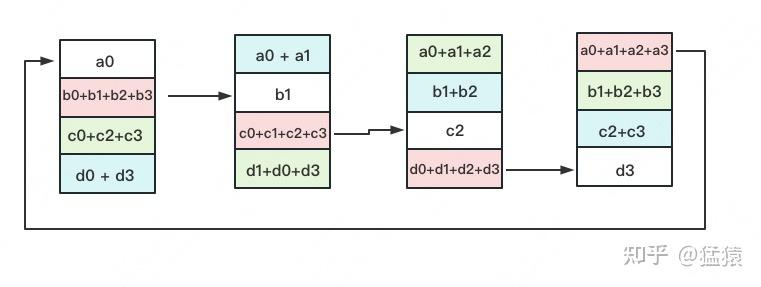
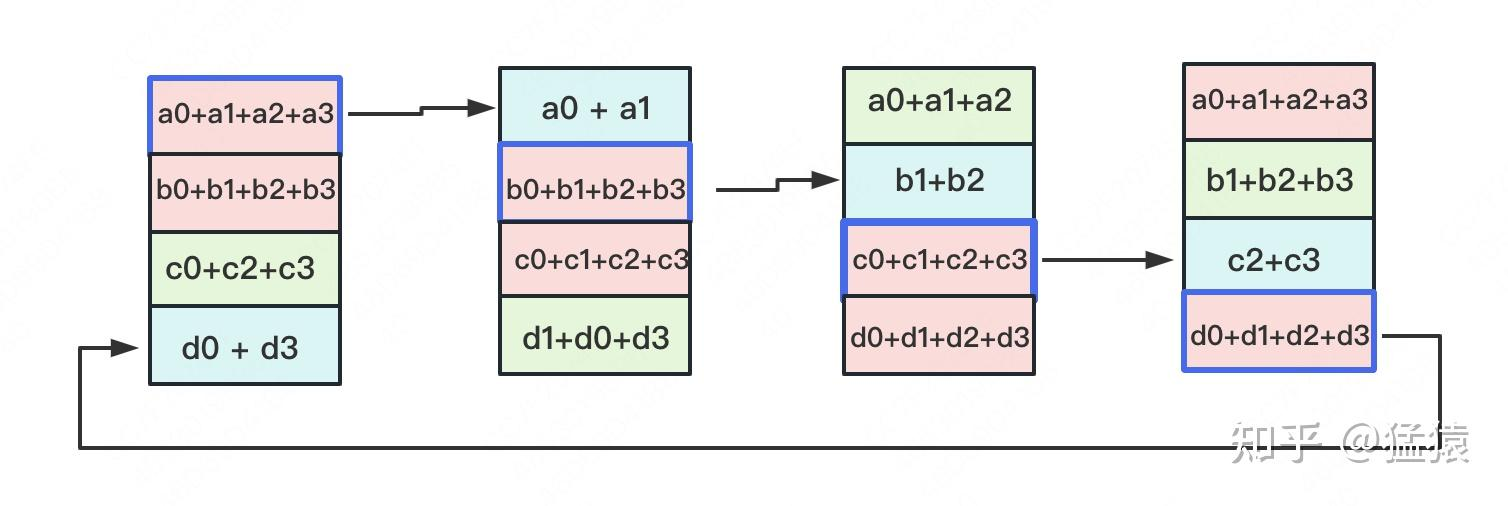
以此类推,同样经过3轮迭代后,使得每块GPU上都汇总到了完整的数据。
Ring-AllReduce通讯量分析
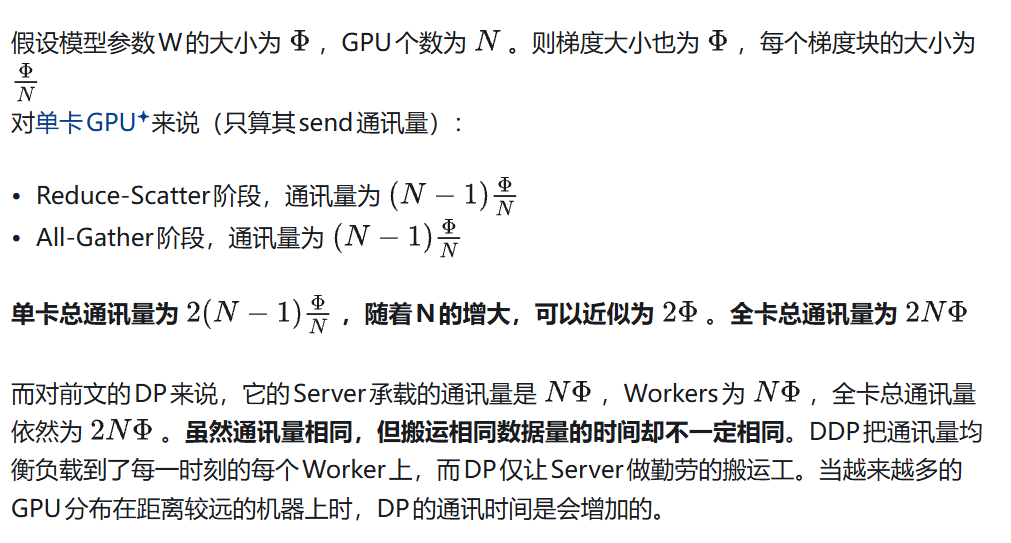
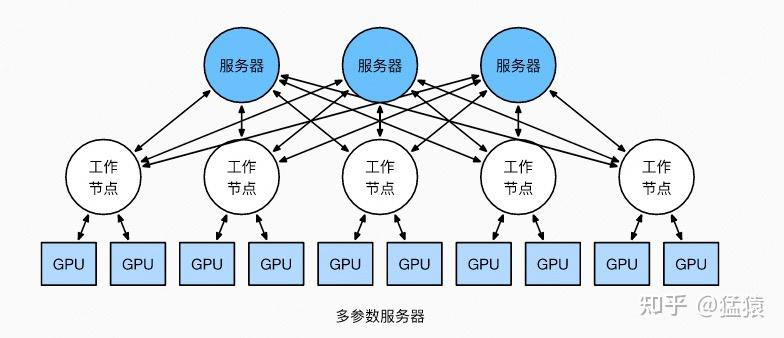
在多Server的模式下,进一步,每个Server可以只负责维护和更新某一块梯度(也可以某块梯度+参数一起维护),此时虽然每个Server仍然需要和所有Worker通讯,但它的带宽压力会小非常多。经过调整设计后,依然可以用来做DDP。虽然这篇文章是用递进式的方式来介绍两者,但不代表两者间一定要决出优劣。我想表达的观点是,方法是多样性的。对参数服务器有兴趣的朋友,可以阅读参考的第1个链接。
最后,请大家记住Ring-AllReduce的方法,因为在之后的ZeRO,Megatron-LM中,它将频繁地出现,是分布式训练系统中重要的算子。
数据并行(DeepSpeed ZeRO 零冗余优化)
在上篇介绍中,通讯负载不均的优化我们解释过了,但还遗留了一个显存开销问题:数据并行中,每个GPU上都复制了一份完整模型,当模型变大时,很容易打爆GPU的显存,那要怎么办呢?
今天这篇文章,我们将介绍由微软开发的ZeRO(零冗余优化),它是DeepSpeed这一分布式训练框架的核心,被用来解决大模型训练中的显存开销问题。ZeRO的思想就是用通讯换显存。
存储消耗
存储分类
大模型训练过程中,GPU需要存以下内容:
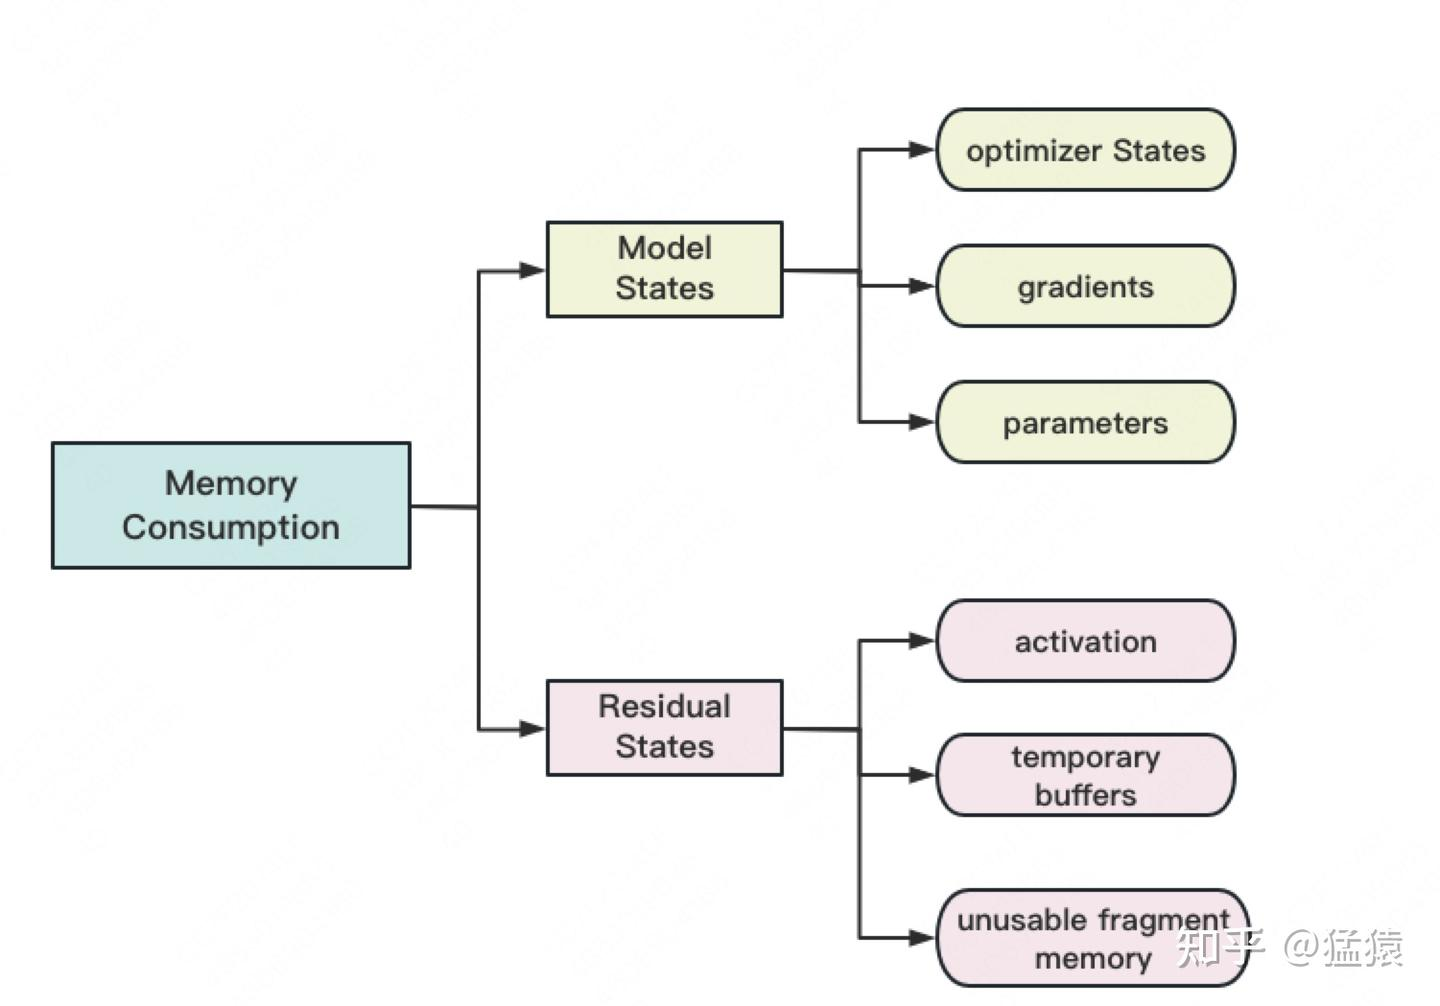
存储主要分为两大块:Model States和Residual States
Model States指和模型本身息息相关的,必须存储的内容,具体包括:
- optimizer states:Adam优化算法中的momentum和variance
- gradients:模型梯度
- parameters:模型参数W
Residual States指并非模型必须的,但在训练过程中会额外产生的内容,具体包括:
- activation:激活值。在流水线并行中我们曾详细介绍过。在backward过程中使用链式法则计算梯度时会用到。有了它算梯度会更快,但它不是必须存储的,因为可以通过重新做Forward来算它。
- temporary buffers: 临时存储。例如把梯度发送到某块GPU上做加总聚合时产生的存储。
- unusable fragment memory:碎片化的存储空间。虽然总存储空间是够的,但是如果取不到连续的存储空间,相关的请求也会被fail掉。对这类空间浪费可以通过内存整理来解决。
精度混合训练
假设模型的参数W大小是$\phi$,那么每一类存储具体占了多大的空间呢?
在分析这个问题前,我们需要来了解精度混合训练。
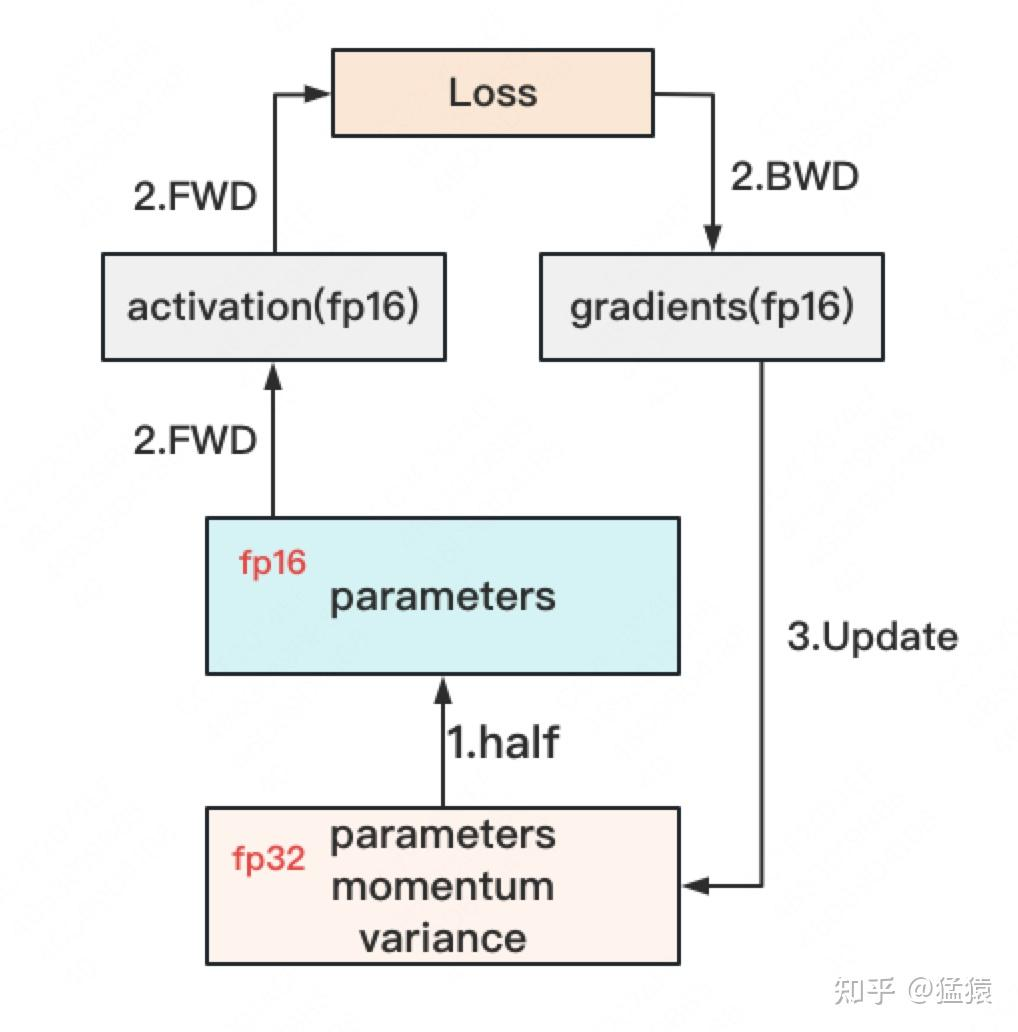
对于模型,我们肯定希望其参数越精准越好,也即我们用fp32(单精度浮点数,存储占4byte)来表示参数W。但是在forward和backward的过程中,fp32的计算开销也是庞大的。那么能否在计算的过程中,引入fp16或bf16(半精度浮点数,存储占2byte),来减轻计算压力呢?于是,混合精度训练就产生了,它的步骤如下图:
- 存储一份fp32的parameter,momentum和variance(统称model states)
- 在forward开始之前,额外开辟一块存储空间,将fp32 parameter减半到fp16 parameter。
- 正常做forward和backward,在此之间产生的activation和gradients,都用fp16进行存储。
- 用fp16 gradients去更新fp32下的model states。
- 当模型收敛后,fp32的parameter就是最终的参数输出。
通过这种方式,混合精度训练在计算开销和模型精度上做了权衡。如果不了解fp32,fp16和bf16的细节也没关系,不影响下文的阅读。只要记住它们所占的存储空间和精度表达上的差异即可。
现在,我们可以来计算模型在训练时需要的存储大小了,假设模型的参数W大小是 $\phi$
,以byte为单位,存储如下:
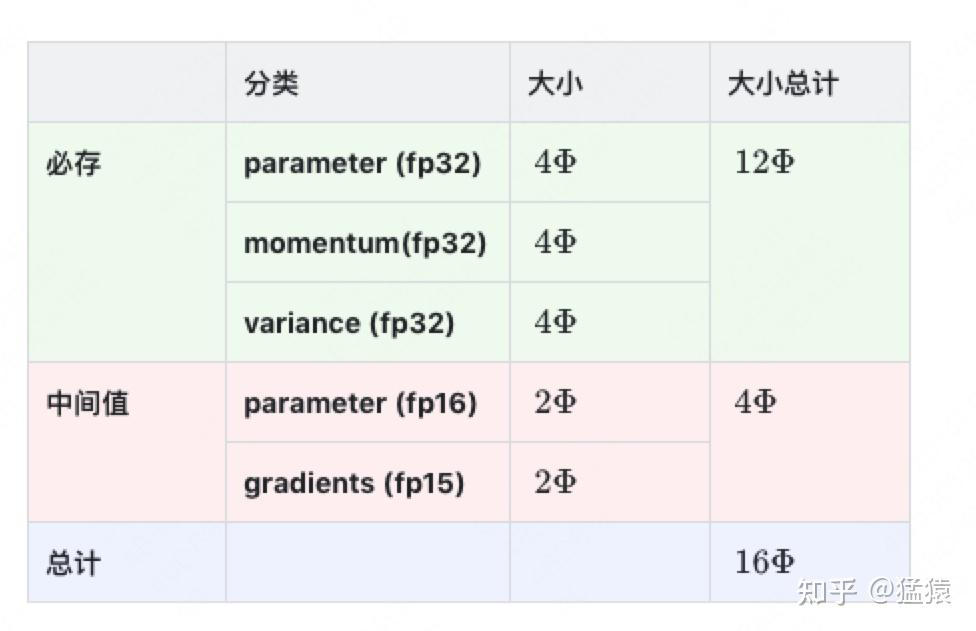
因为采用了Adam优化,所以才会出现momentum和variance,当然你也可以选择别的优化办法。因此这里为了更通用些,记模型必存的数据大小为 $K\phi$
。因此最终内存开销为: $2\phi+2\phi+K\phi$
另外,这里暂不将activation纳入统计范围,原因是:
activation不仅与模型参数相关,还与batch size相关
activation的存储不是必须的。存储activation只是为了在用链式法则做backward的过程中,计算梯度更快一些。但你永远可以通过只保留最初的输入X,重新做forward来得到每一层的activation(虽然实际中并不会这么极端)。
因为activation的这种灵活性,纳入它后不方便衡量系统性能随模型增大的真实变动情况。因此在这里不考虑它,在后面会单开一块说明对activation的优化。
ZeRO-DP
知道了什么东西会占存储,以及它们占了多大的存储之后,我们就可以来谈如何优化存储了。
注意到,在整个训练中,有很多states并不会每时每刻都用到,举例来说;
Adam优化下的optimizer states只在最终做update时才用到
数据并行中,gradients只在最后做AllReduce和updates时才用到
参数W只在做forward和backward的那一刻才用到
诸如此类
所以,ZeRO想了一个简单粗暴的办法:如果数据算完即废,等需要的时候,我再想办法从个什么地方拿回来,那不就省了一笔存储空间吗?
沿着这个思路,我们逐一来看ZeRO是如何递进做存储优化的。
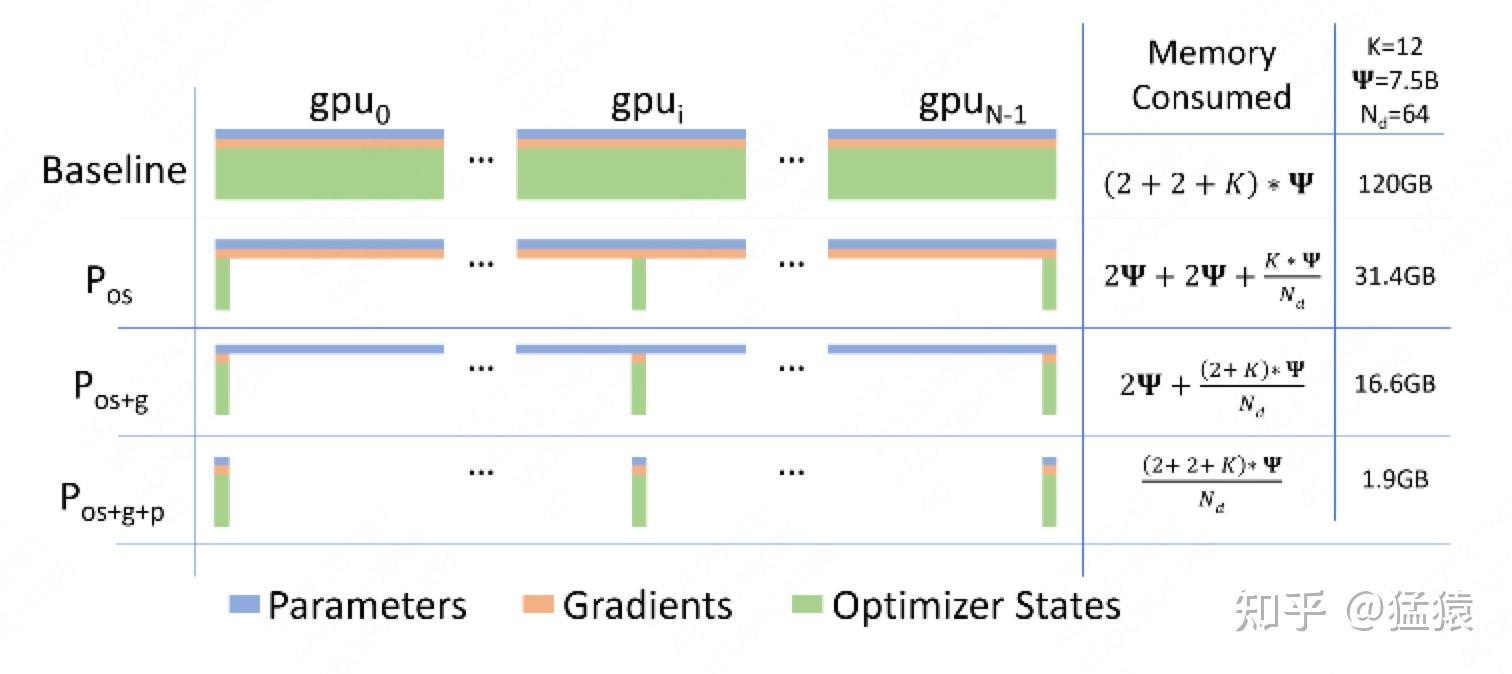
$P_{os}$:优化状态分割
首先,从 optimizer state开始优化。将optimizer state分成若干份,每块GPU上各自维护一份。这样就减少了相当一部分的显存开销。如下图:
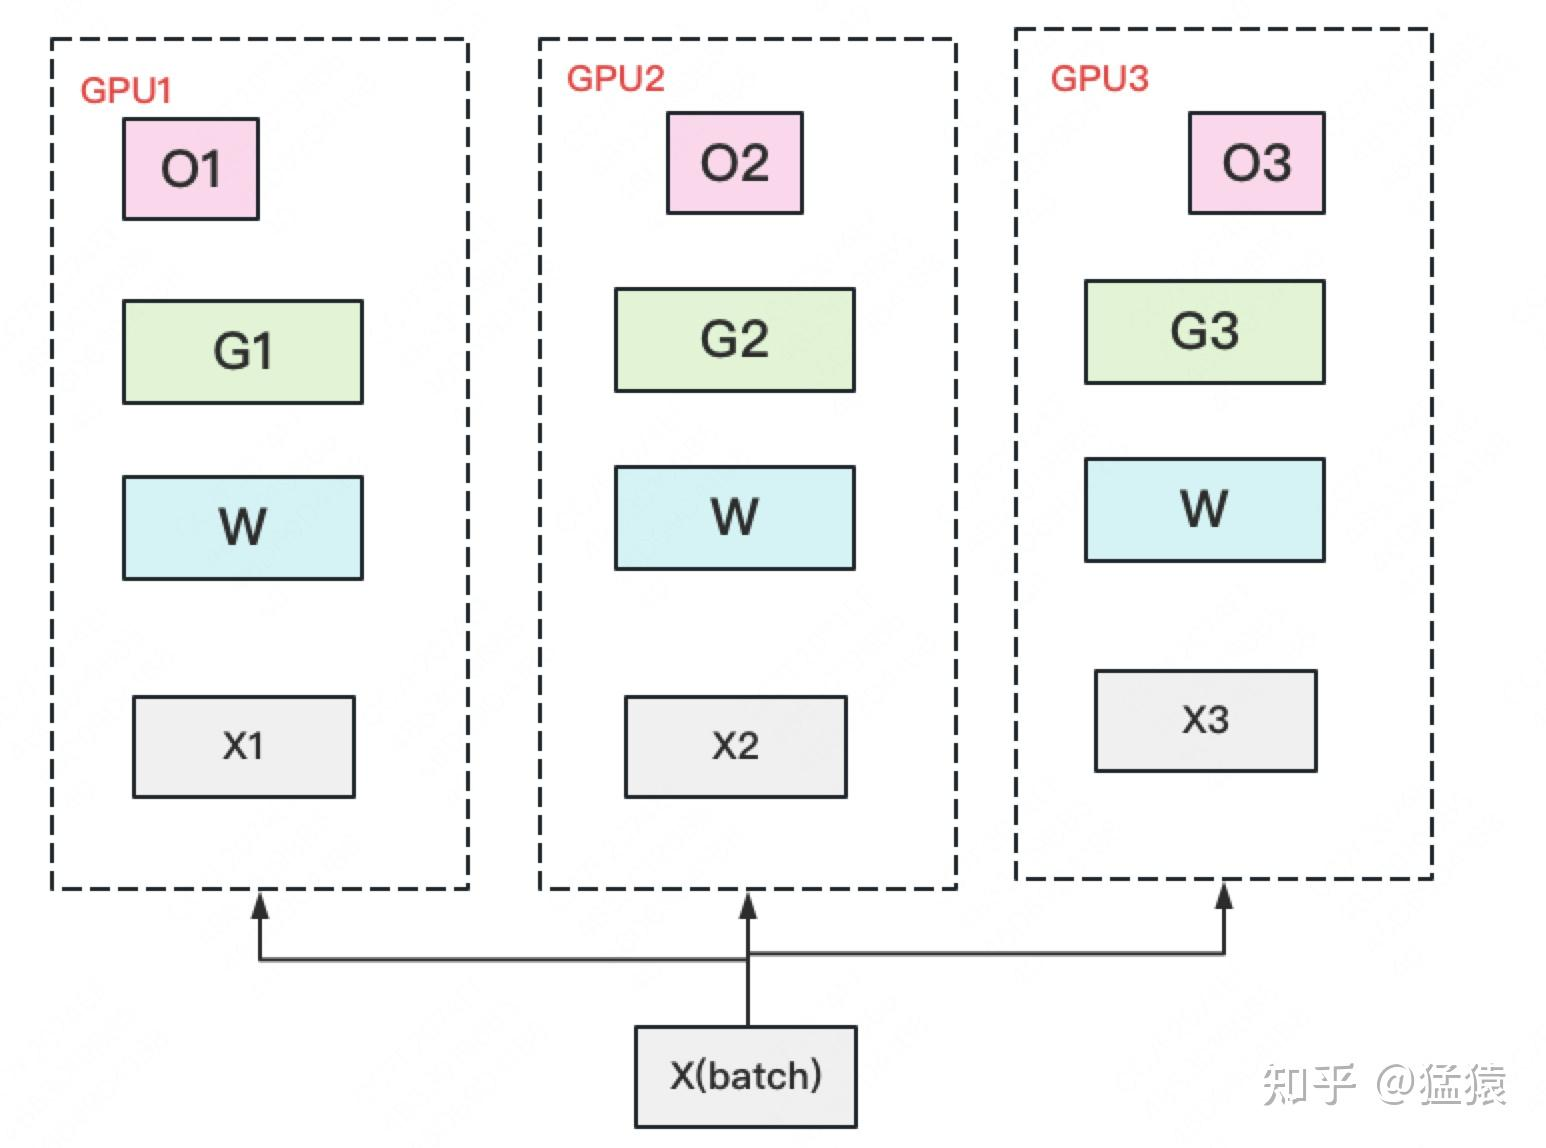
复习一下,此时W=fp16,G=fp16,O=fp32。此时,整体数据并行的流程如下:
(1)每块GPU上存一份完整的参数W。将一个batch的数据分成3份,每块GPU各吃一份,做完一轮foward和backward后,各得一份梯度。
(2)对梯度做一次AllReduce,得到完整的梯度G,产生单卡通讯量 $2\phi$
。为了表达简明,这里通讯量我们就不再换算成byte了,而直接根据参数量来计算。对AllReduce(reduce-scatter + all-gather)不熟悉的朋友,可以先去看上一篇文章(PS: 在zero1代码早期实践中,这里对梯度使用的是AllReduce,但是你可以发现,其实只要做一次ReduceScatter就完全够用了,产生的通讯量为 $\phi$
)
(3)得到完整梯度G,就可以对权重进行更新。我们知道W的更新由optimizer states和梯度共同决定。由于每块GPU上只保管部分optimizer states,只能将相应的W(蓝色部分)进行更新。(2)和(3)可以用下图表示:
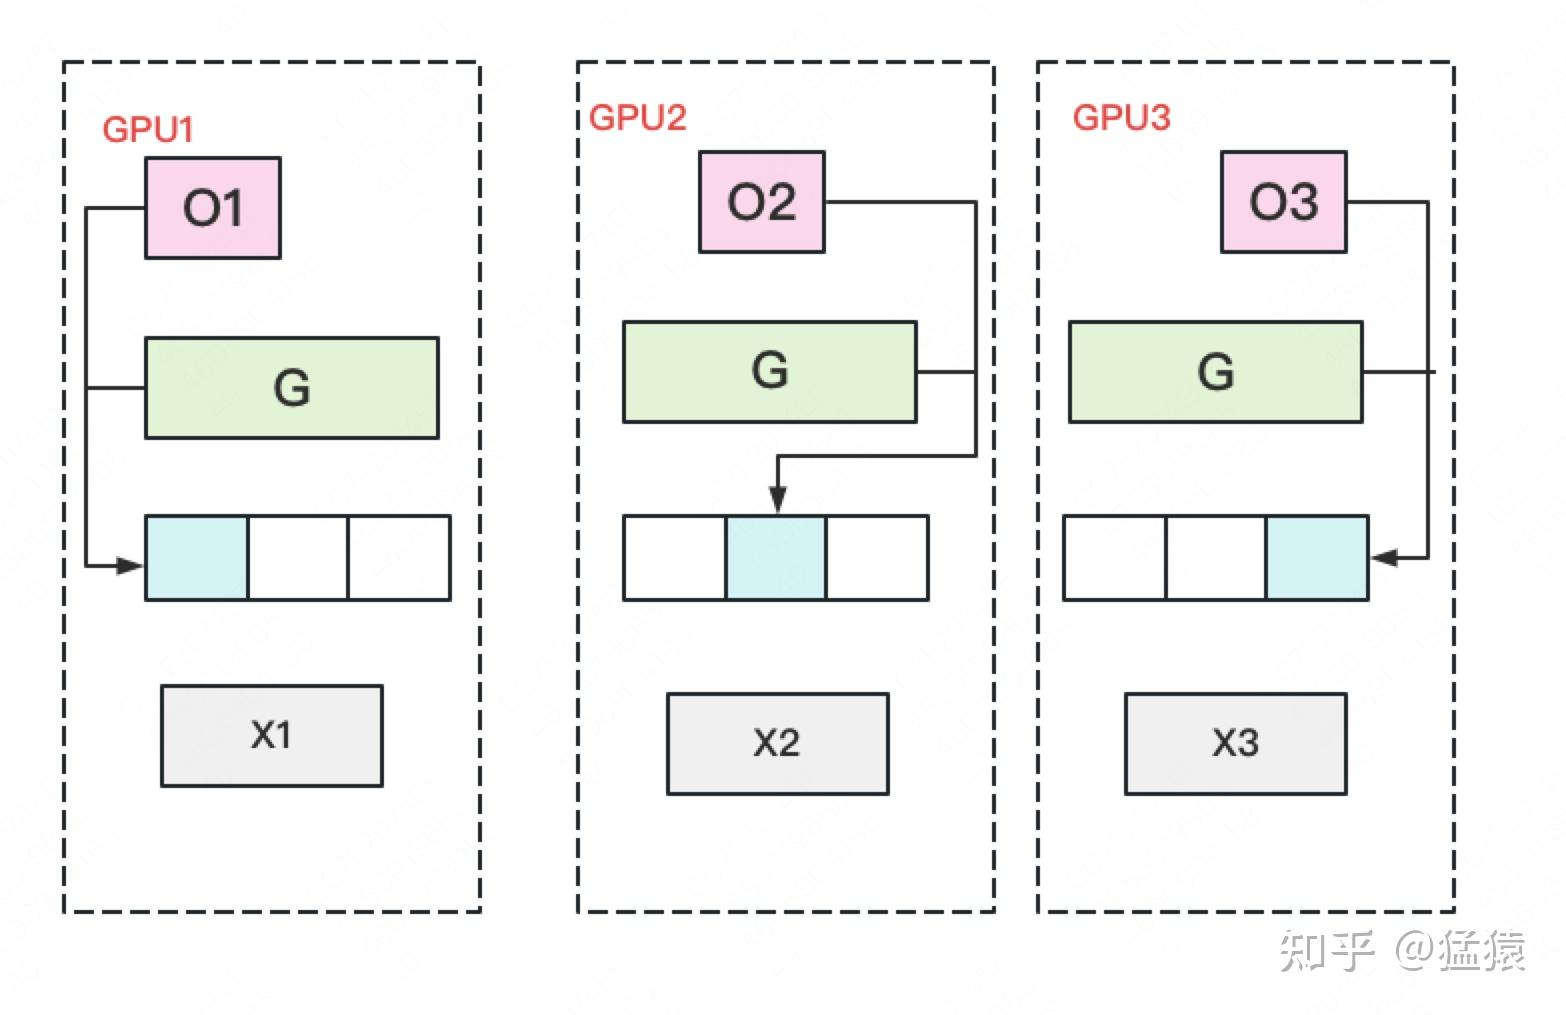
(4)此时,每块GPU上都有部分W没有完成更新(图中白色部分)。所以我们需要对W做一次All-Gather(此时的W已经执行过上述的fp16._copy(fp32)步骤),从别的GPU上把更新好的部分W取回来。产生单卡通讯量 $\phi$
。
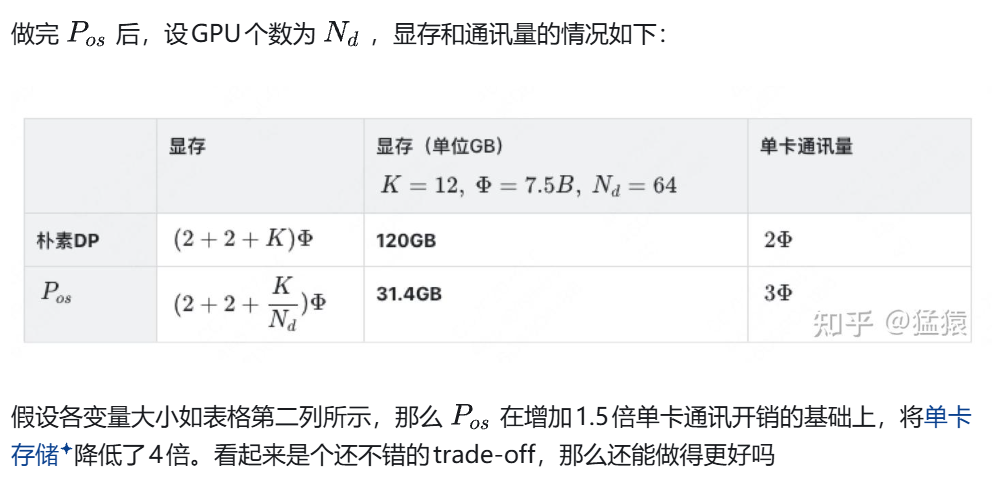
这里的K可以理解为Optimizer的参数量,W和G都是2Byte
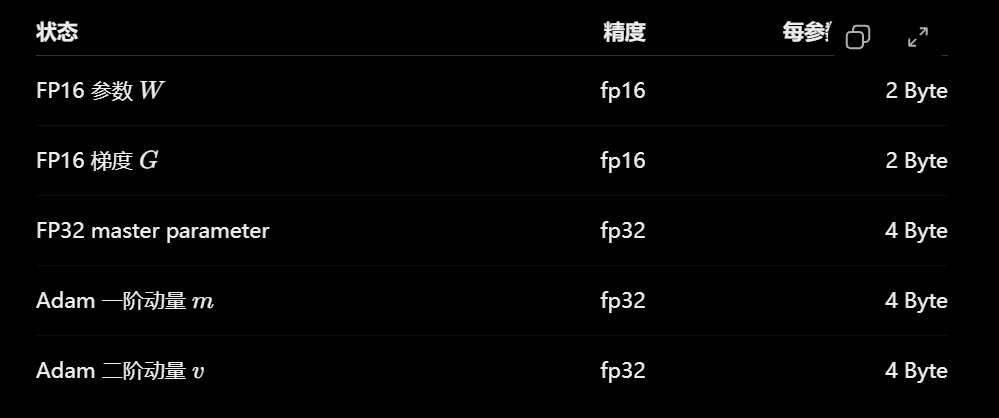
这里写的很复杂而且难以理解,我的理解是,这里最根本的是O代表的Optimizer是可以拆分的,所以拆到了三个GPU上,但是要更新这一个GPU的这一个数据所以需要做AllReduce/Reduce-Scatter和All-Gather,然后这个W作为O的投影它是必须要是完整的,所以它需要做All-Gather去整合数据。
假设各变量大小如表格第二列所示,那么
在增加1.5倍单卡通讯开销的基础上,将单卡存储降低了4倍。看起来是个还不错的trade-off,那么还能做得更好吗
$P_{os} + P_g$:优化状态与梯度分割
现在,更近一步,我们把梯度也拆开,每个GPU格子维护一块梯度。
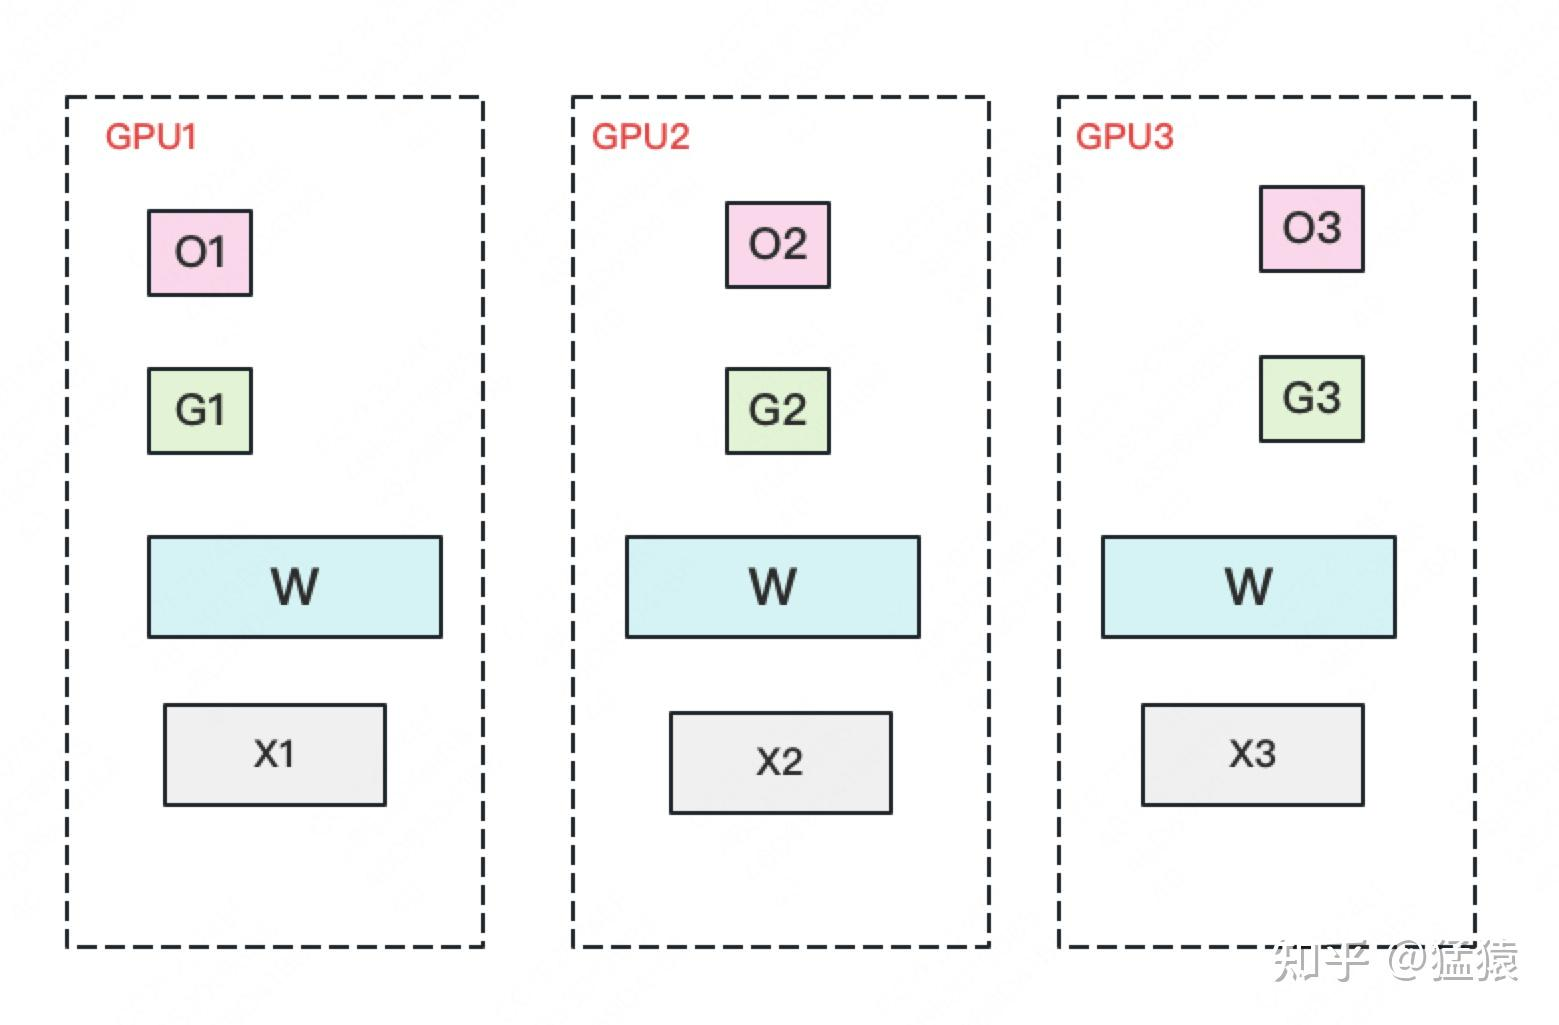
此时,数据并行的整体流程如下:
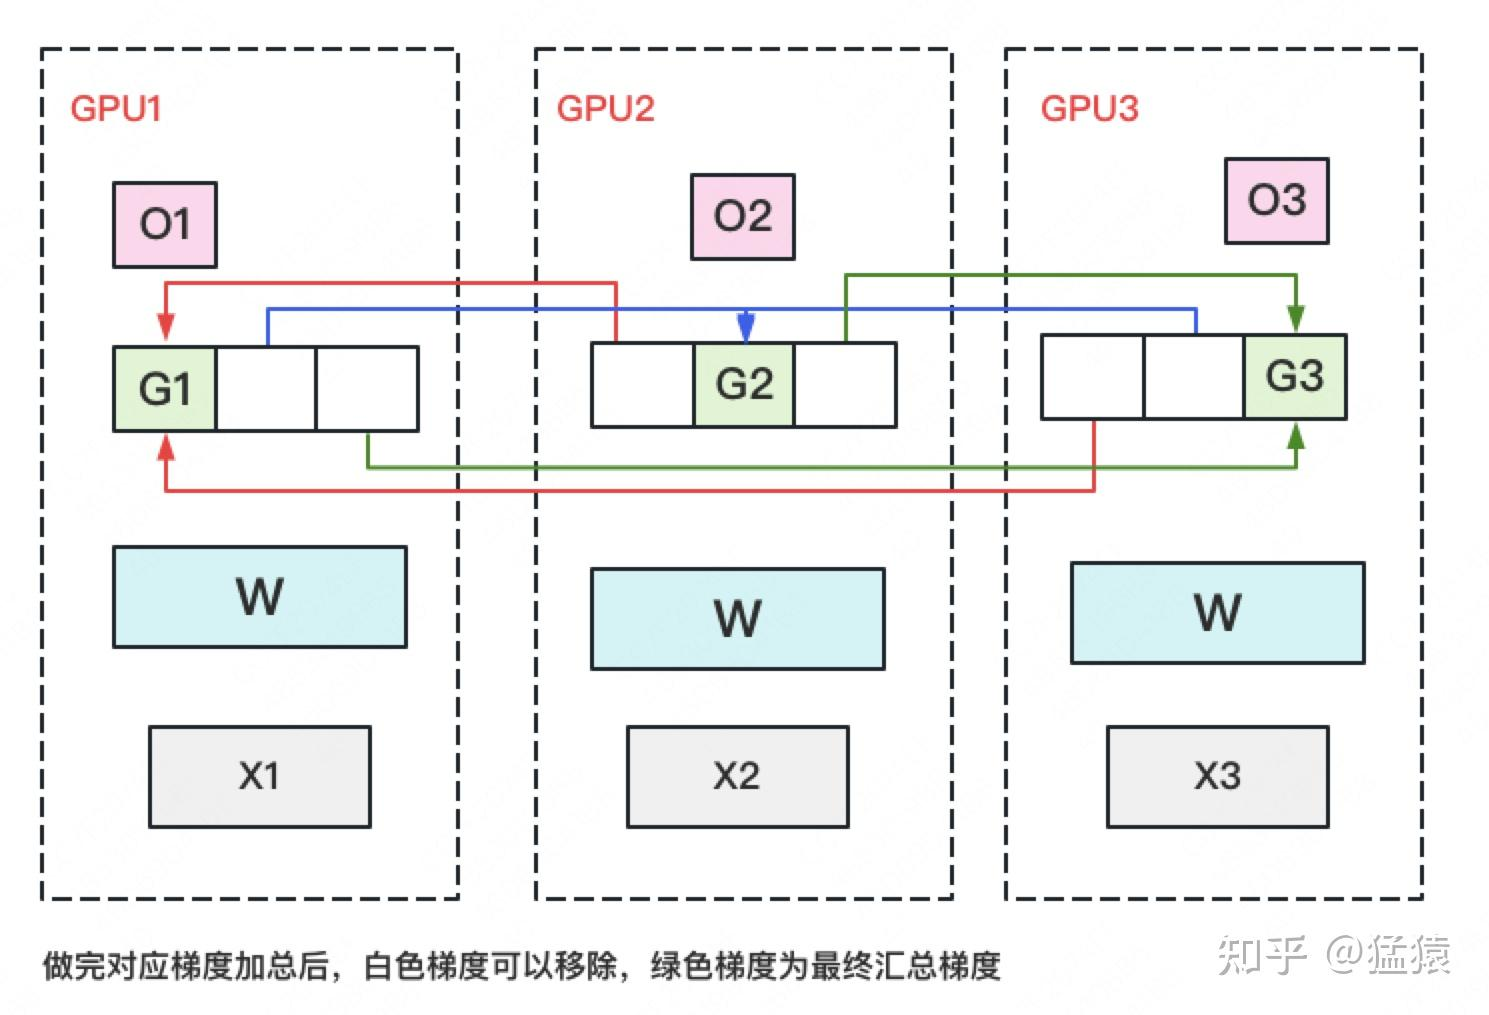
(1)每块GPU上存一份完整的参数W。将一个batch的数据分成3份,每块GPU各吃一份,做完一轮foward和backward后,算得一份完整的梯度(下图中绿色+白色)。
(2)对梯度做一次Reduce-Scatter,保证每个GPU上所维持的那块梯度是聚合梯度。例如对GPU1,它负责维护G1,因此其他的GPU只需要把G1对应位置的梯度发给GPU1做加总就可。汇总完毕后,白色块对GPU无用,可以从显存中移除。单卡通讯量 $\phi$
。(1)和(2)见下图:
(3)每块GPU用自己对应的O和G去更新相应的W。更新完毕后,每块GPU维持了一块更新完毕的W。同理,对W做一次All-Gather,将别的GPU算好的W同步到自己这来。单卡通讯量 $\phi$。
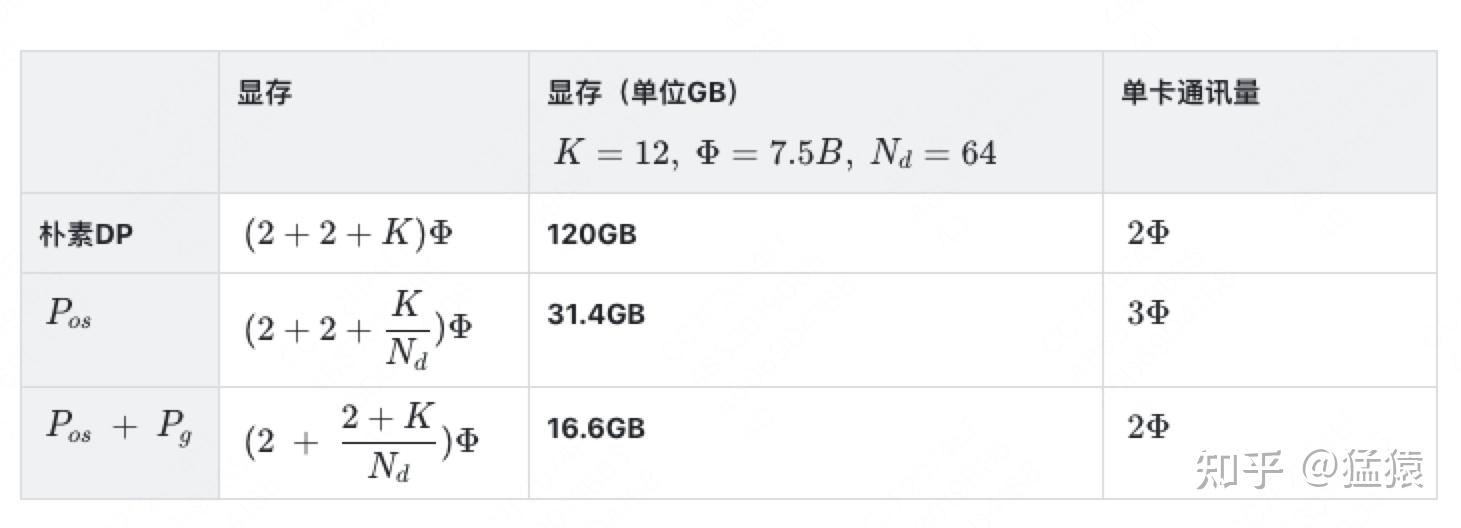
这里的通信量下降是因为ZeRO-1做了一次不必要的完整AllReduce,而我们只需要做ReduceScatter即可。
$P_{os} + P_g + P_p$:优化状态、梯度与参数分割
看到这里,也许你有点感觉了,ZeRO的思想就是:万物皆可切,万物皆可抛。所以现在,我们把参数也切开。每块GPU置维持对应的optimizer states,gradients和parameters(即W)。
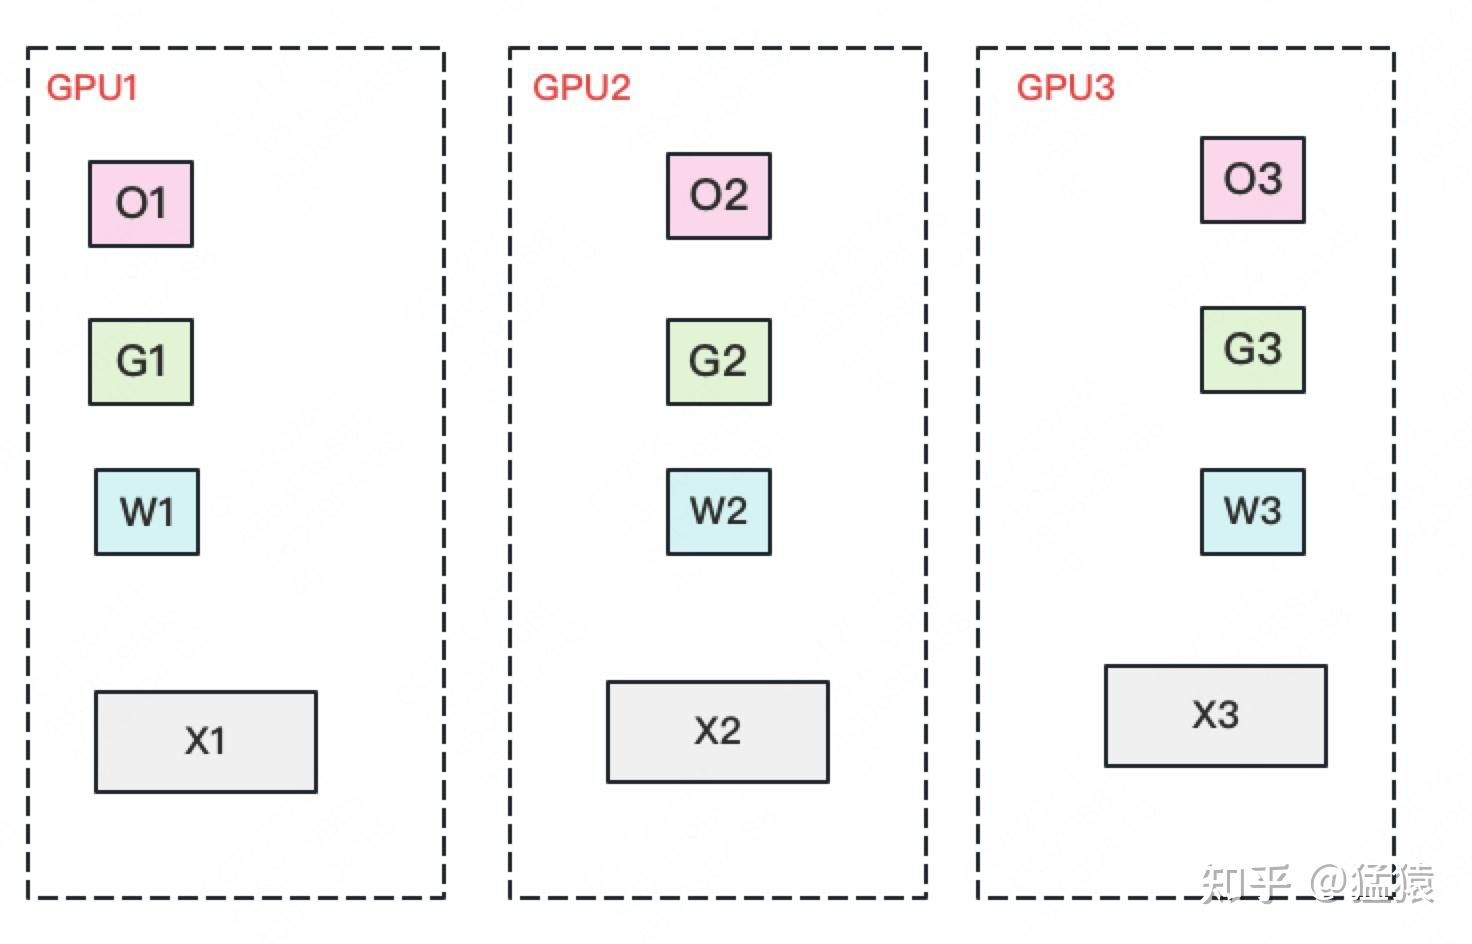
数据并行的流程如下:
(1)每块GPU上只保存部分参数W。将一个batch的数据分成3份,每块GPU各吃一份。
(2)做forward时,对W做一次All-Gather,取回分布在别的GPU上的W,得到一份完整的W,单卡通讯量$\phi$
。forward做完,立刻把不是自己维护的W抛弃。
(3)做backward时,对W做一次All-Gather,取回完整的W,单卡通讯量
。backward做完,立刻把不是自己维护的W抛弃。
(4)做完backward,算得一份完整的梯度G,对G做一次Reduce-Scatter,从别的GPU上聚合自己维护的那部分梯度,单卡通讯量 $\phi$
。聚合操作结束后,立刻把不是自己维护的G抛弃。
(5)用自己维护的O和G,更新W。由于只维护部分W,因此无需再对W做任何AllReduce操作。
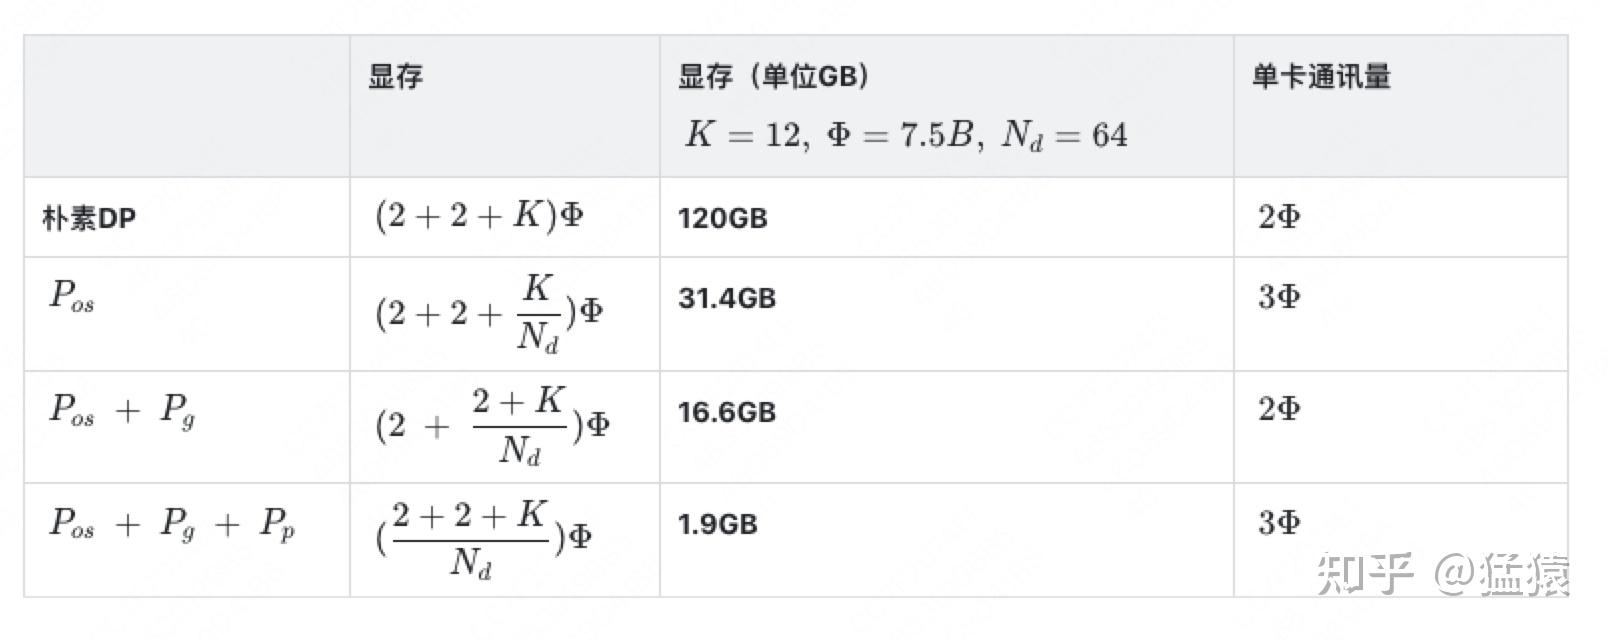
到这一步,我们用1.5倍的通讯开销,换回近120倍的显存。只要梯度计算和异步更新做的好,通讯时间大部分可以被计算时间隐藏,因此这样的额外通讯开销,也是划算的。
到这里,我们可以放出原始论文中的说明图了,经过以上分析,这张说明图是不是瞬间就能看懂了。
仔细一想,ZeRO其实掌握了降本增效的精髓:用完即弃,需要再补。反正我补一个和你差不多的,也不会花费很多通(找)讯(人)时间,还大大降低了我的成本。模型的每一层多算(造)几(轮)遍(子)有啥关系呢,反正在我的预算里每个人都一刻不停地干活,就行啦!
ZeRO VS 模型并行
知道模型并行的朋友,可能会想,既然ZeRO都把参数W给切了,那它应该是个模型并行呀?为什么要归到数据并行里呢?
其实ZeRO是模型并行的形式,数据并行的实质。
模型并行,是指在forward和backward的过程中,我只需要用自己维护的那块W来计算就行。即同样的输入X,每块GPU上各算模型的一部分,最后通过某些方式聚合结果。
但对ZeRO来说,它做forward和backward的时候,是需要把各GPU上维护的W聚合起来的,即本质上还是用完整的W进行计算。它是不同的输入X,完整的参数W,最终再做聚合。
ZeRO-R
说完了以上对model states的显存优化,现在来看对residual states的优化。
$P_a$: Partitioned Activation Checkpointing
前面说过,对activation的存储是灵活的。不像optimizer states,gradients和parameters对模型更新是必须的,activation只是起到加速梯度计算的作用。因此,在哪几层保存activation,保存哪些activation都是可以灵活设置的。同样,我们也可以仿照以上切割方式,每块GPU上只维护部分的activation,需要时再从别的地方聚合过来就行。需要注意的是,activation对显存的占用一般会远高于模型本身,通讯量也是巨大的,所以这块要灵活、有效地实验设计。
$C_B$Constant Size Buffer
固定大小的内存buffer,它的目的在于:
提升带宽利用率。当GPU数量上升,GPU间的通讯次数也上升,每次的通讯量可能下降(但总通讯量不会变)。数据切片小了,就不能很好利用带宽了。所以这个buffer起到了积攒数据的作用:等数据积攒到一定大小,再进行通讯。
使得存储大小可控。在每次通讯前,积攒的存储大小是常量,是已知可控的。更方便使用者对训练中的存储消耗和通讯时间进行预估。
$M_D$Memory Defragmentation
在前文提过,设置机制,对碎片化的存储空间进行重新整合,整出连续的存储空间。防止出现总存储足够,但连续存储不够而引起的存储请求
ZeRO-Offload与ZeRO-Infinity
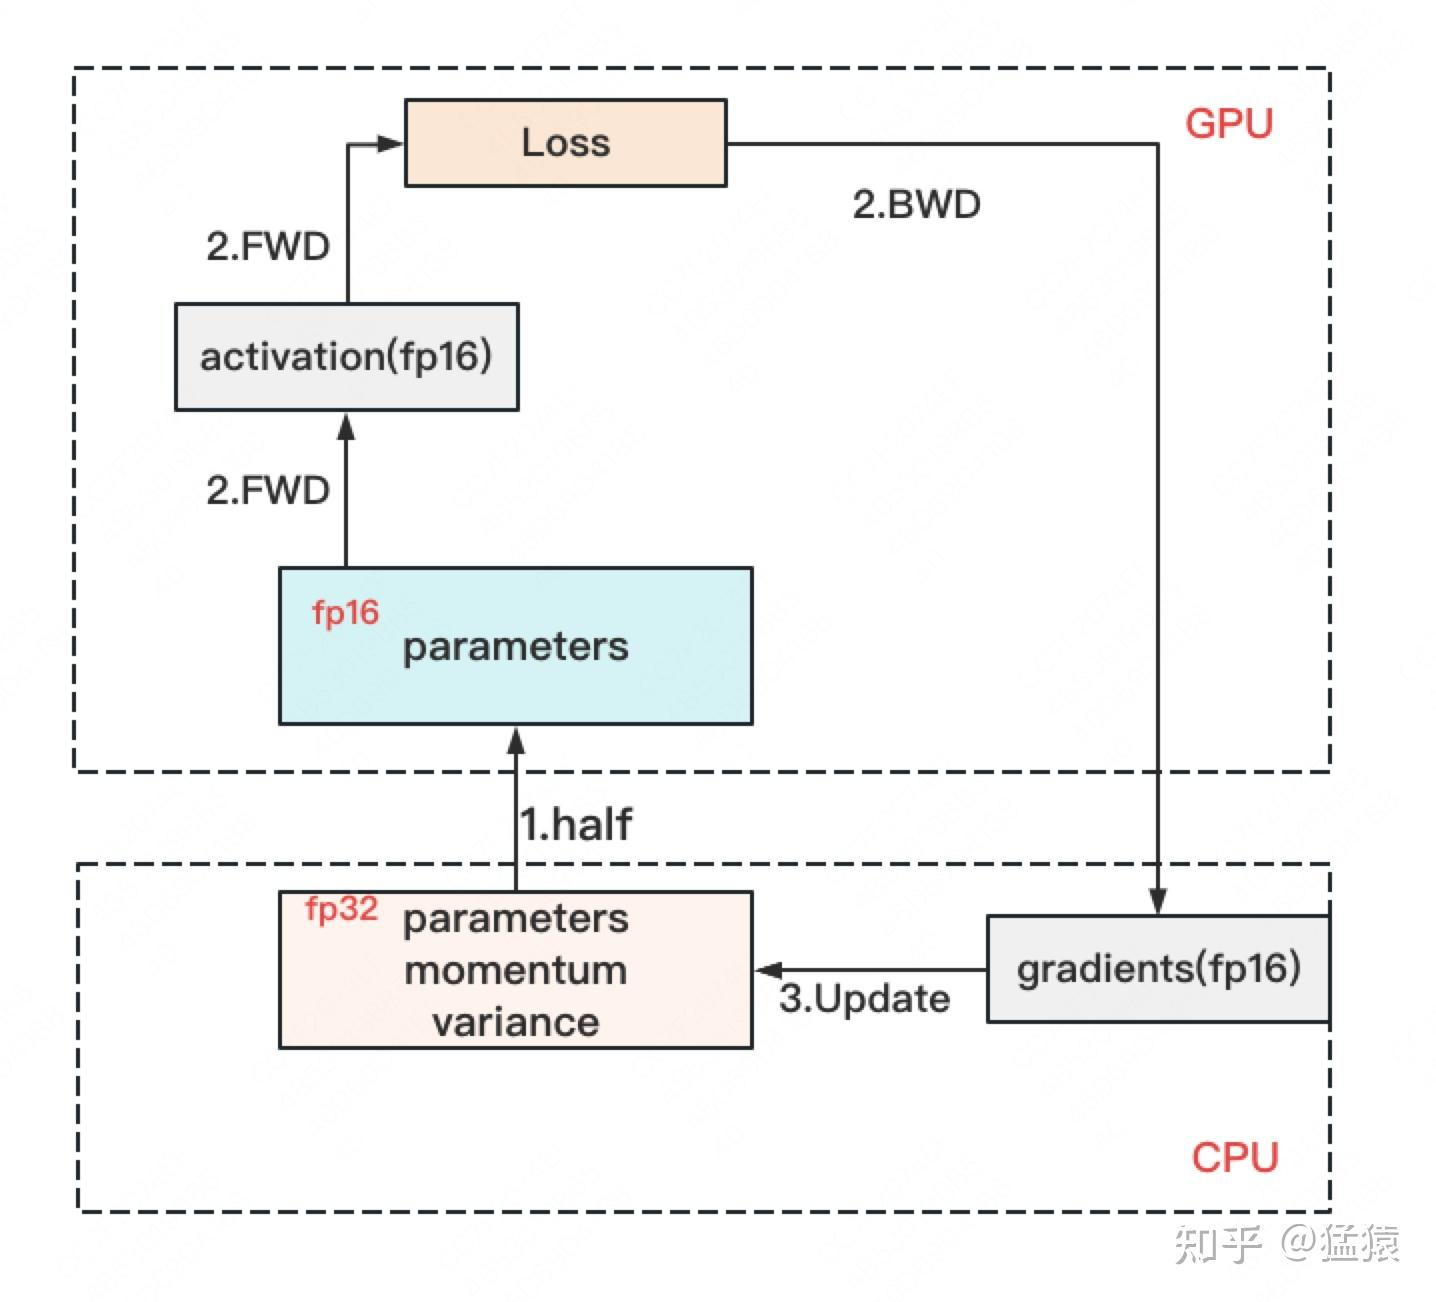
最后,简单介绍一下ZeRO-Offload。它的核心思想是:显存不够,内存来凑。如果我把要存储的大头卸载(offload)到CPU上,而把计算部分放到GPU上,这样比起跨机,是不是能既降显存,也能减少一些通讯压力呢?
ZeRO-Offload的做法是:
forward和backward计算量高,因此和它们相关的部分,例如参数W(fp16),activation,就全放入GPU。
update的部分计算量低,因此和它相关的部分,全部放入CPU中。例如W(fp32),optimizer states(fp32)和gradients(fp16)等。
具体切分如下图:
ZeRO-infinity也是同理,它们在解决的事情都是:找个除GPU之外的地方,存数据