项目提交人:李澍
设计与实现
ONNX动态维度表示
之前版本的Shape本质上是 vector
例如输入为:
["batch", 3, ?, 2]
class DimensionKind(str, Enum):

    FIXED = "fixed"
    SYMBOLIC = "symbolic"
    UNKNOWN = "unknown"

@dataclass(frozen=True)
class DimensionSpec():

    kind: DimensionKind
    value: Optional[int] = None
    symbolic: Optional[str] = None

ShapeSpec = tuple[DimensionSpec,...]
我们在代码中如上定义,则对于各个维度我们能表示它的类型与具体的数值,避免在信息传递时丢失它的语义。例如对于DimensionKind==FIXED 的维度,我们标注value,对于DimensionKind==SYMBOLIC 的维度,我们标注它的名字例如batch,这样一来我们保存了输入的全部信息。对于未知维度,我们只标注kind,其余的保持为None 。
具体在读入方面,我们定义了函数去从ONNX读取声明,由于ONNX使用Protobuf表示Shape,每个维度通常有三种状态:dim_value,dim_param,none。这里的代码如下:
def _parse_shape_spec(shape):
    dimensions = []

    for dimension in shape.dim:
        kind = dimension.WhichOneof("value")

        if kind == "dim_value":
            dimensions.append(
                DimensionSpec(
                    kind=DimensionKind.FIXED,
                    value=dimension.dim_value,
                )
            )
        elif kind == "dim_param" and dimension.dim_param:
            dimensions.append(
                DimensionSpec(
                    kind=DimensionKind.SYMBOLIC,
                    symbolic=dimension.dim_param,
                )
            )
        else:
            dimensions.append(
                DimensionSpec(kind=DimensionKind.UNKNOWN)
            )

    return tuple(dimensions)
最后,考虑到InfiniteTensor创建Tensor时,仍然要求具体的整数Shape,所以我们还构造了函数去处理这一逻辑,具体来说在模型刚导入还没有收到真实输入时,对于已知的维度使用对应的值,其它两种类型的维度临时设置为1.
Shape Tensor 及相关算子实现
考虑到Shape Tensor实际上保存的时Tensor的形状信息,它同时也要计算Shape Tensor的数据,这是由于动态Reshape最终读取的时Shape Tensor的数据。
Shape算子
在inferShape中直接输出输入数据的维度:
optional<vector<Shape>> ShapeObj::inferShape(
    const TensorVec &inputs) {
    return {{{static_cast<int>(inputs[0]->getRank())}}};
}
在inferDataType 输出使用Int64 :
vector<DataType>
ShapeObj::inferDataType(const TensorVec &inputs) const {
    IT_ASSERT(inputs.size() == 1);
    return {DataType::Int64};
}
在CPU Kernel中输出保存的数据:
const Shape inputShape = op->getInputs(0)->getDims();
auto *output =
    op->getOutput()->getRawDataPtr<int64_t *>();

for (size_t i = 0; i < inputShape.size(); ++i)
    output[i] = static_cast<int64_t>(inputShape[i]);
最后通过REGISTER_KERNEL将它注册到CPU Kernel表。
Gather算子
Gather算子的目的是从完整Shape中取出一个维度。
在inferShape中,它先删掉data的axis维度,再在对应位置插入indices的所有维度:
optional<vector<Shape>> GatherObj::inferShape(const TensorVec &inputs) {
    auto dims0 = inputs[0]->getDims();
    auto dims1 = inputs[1]->getDims();

    //IT_ASSERT(CheckIndexValid());

    Shape dim = dims0;
    dim.erase(dim.begin() + axis);
    dim.insert(dim.begin() + axis, dims1.begin(), dims1.end());
    return {{dim}};
}
在inferDataType中,我们保持Gather输出dtype与第一个输入相同:
vector<DataType> GatherObj::inferDataType(const TensorVec &inputs) const {
    IT_ASSERT(inputs.size() == 2);
    auto index_dtype = inputs[1]->getDType();
    IT_ASSERT(index_dtype == DataType::Int32 || index_dtype == DataType::Int64);
    return {inputs[0]->getDType()};
}
在CPU数据计算中,我们的设计是,先将data按axis分成outer*axisDim*inner , 这样的话一个index实际选择的是axis上的一段连续的数据,每段有inner个元素。接着计算输入、输出偏移:
inputElementOffset =
    (outerIndex * axisDim + index) * inner;

outputElementOffset =
    (outerIndex * indexCount + indexOffset) * inner;
最后用memcpy()复制整个连续片段。
Unsqueeze和Squeeze
Unsqueeze的目的是给Tensor增加大小为1的维度,具体实现为:
optional<vector<Shape>> UnsqueezeObj::inferShape(const TensorVec &inputs) {
    Shape inputDim = inputs[0]->getDims();
    auto rank = inputs[0]->getRank() + axes.size();
    Shape outputShape(rank, -1);
    Shape axesCopy = axes;
    for (size_t i = 0; i < axesCopy.size(); ++i) {
        axesCopy[i] = get_real_axis(axesCopy[i], rank);
        IT_ASSERT(outputShape[axesCopy[i]] == -1, "Axes have duplicate");
        outputShape[axesCopy[i]] = 1;
    }
    auto it = inputDim.begin();
    for (size_t i = 0; i < outputShape.size(); ++i) {
        if (outputShape[i] == -1) {
            outputShape[i] = *it++;
        }
    }
    return {{outputShape}};
}
Squeeze执行相反的操作,删除大小为1的维度。
这里Unsqueeze和Squeeze 不改变元素数量和排列顺序,但输出是另一个Tensor,它仍然需要获得数据,所以在CPU注册中把这些操作接到不改变数据排列的Kernel上
Concat算子
Concat 将多个 Shape Tensor 片段拼成完整目标 Shape。
所以Concat的infershape会在检查axis一致后将concat上的长度相加:
optional<vector<Shape>> ConcatObj::inferShape(const TensorVec &inputs) {
    Shape dims = inputs[0]->getDims();
    auto rank = inputs[0]->getRank();
    if (inputs.size() == 2) {
        for (size_t i = 0; i < inputs.size(); ++i) {
            if (inputs[i]->size() == 0) {
                return {{inputs[1 - i]->getDims()}};
            }
        }
    }
    ShapeElem n = dims.at(dim);
    for (auto itr = inputs.begin() + 1; itr != inputs.end(); ++itr) {
        auto input = *itr;
        auto iDims = input->getDims();
        IT_ASSERT(rank == input->getRank());
        for (auto i = 0; i < (int)rank; i++) {
            if (i == dim) {
                n += iDims.at(i);
                continue;
            }
            IT_ASSERT(iDims.at(i) == dims.at(i));
        }
    }
    dims[dim] = n;
    return {{dims}};
CPU Kernel 按 axis 将每个输入的真实数据依次复制到输出内存.
举例来说是:[batch] + [6] → [batch, 6]
Cast算子
目的是让所有输入使用相同的dtype
vector<DataType> CastObj::inferDataType(const TensorVec &inputs) const {
    auto input_dataType = inputs[0]->getDType();
    auto output_dataType = getOutputDataType();
    for (const auto &tensor : inputs)
        IT_ASSERT(input_dataType == tensor->getDType());
    return vector(numOutputs(), output_dataType);
}

optional<vector<Shape>> CastObj::inferShape(const TensorVec &inputs) {
    const auto A = inputs[0];
    return {{A->getDims()}};
}
CPU Kernel 根据输入和目标 dtype 执行逐元素类型转换。
动态Shape执行流程
动态Reshape相比于静态Shape特殊的地方在于,它的目标Shape来自运行时计算得到的Shape Tensor
Input X
  │
  ├── Shape ── Gather ── Unsqueeze ──┐
  │                                  │
  └─────────────────────────────── Concat ── Reshape
而模型的导入阶段只能知道Concat后的shape是怎样的,但并不知道它的数据究竟是什么,这也是为什么我们要在上面执行每个算子的kernel去算具体的数据。
所以我们将动态执行分成两个大阶段,一、计算Shape Tensor,确定本次真实的Shape,二、按照真实Shape执行普通数据计算。
因此,项目最终形成的执行流程是:更新输入Shape → 初步inferShape → 初步分配内存 → 写入本次输入数据 → 执行Shape Tensor子图 → 解析动态Reshape输出shape → 重新传播下游Shape → 重新规划内存 → 执行完整计算图 → 输出
首先在模型导入阶段,会构造一个OnnxStub,这时会创建普通算子和ShapeTensor算子,然后会将动态Reshape数据的输入和Shape Tensor输入链接起来,并完成首次的内存分配,并将initializer写入对应Tensor。
然后从set_input 开始,首先检查输入是否合理,然后更新输入的TensorShape,具体而言是调用change_shape:
void GraphHandlerObj::change_shape(
    const vector<int> &shape,
    int tensorId) {
    auto tensor = g->getTensor(tensorId);
    IT_ASSERT(tensor != nullptr);
    IT_ASSERT(shape.size() != 0);
    tensor->setShape(shape);
}
更新输入后执行shape_infer:
void GraphObj::shape_infer() {
    for (auto &op : ops) {
        auto ans = op->inferShape();

        for (int i = 0; i < ans.value().size(); ++i) {
            if (newShape != oldShape)
                tensor->setShape(newShape);
        }
    }
}
这里按照图中算子的顺序重新推导出Shape。然后通过self.init() 分配内存并且重新写入模型initializer 。
完成后,调用者写入输入stub.inputs["x"].copyin_numpy(x) ,然后调用stub.run() ,进入CPU Runtime。
首先我们执行了动态Shape的准备阶段prepareRuntimeShapes() ,这里的目的是找到算子类型是Reshape且需要使用运行时Shape Tensor的算子。然后从动态Reshape的第二个输入开始,沿着Tensor的生产者向前追踪,收集到需要提前执行的算子,然后对这些算子进行拓扑排序,保证生产者出现在消费者之前,然后通过Runtime遍历拓扑排序后的算子。
for (const Operator &op : graph->getOperators()) {
    if (requiredShapeOps.count(op.get())) {
        const KernelAttrs attrs{
            device,
            op->getOpType().underlying()
        };

        Kernel *kernel =
            kernelRegistry.getKernel(attrs);

        kernel->compute(op, runtime);
    }
}
这一步结束后,我们的动态Reshape的第二个输入就已经包含真实的数据了。然后就可以更新Reshape的输出。
动态 Reshape 输出 Shape 更新后,立即调用graph->shape_infer(); 这里是为了传播动态Reshape的真实输出Shape。
如果任何动态Reshape的输出发生了变化,则根据之前选择的分配模式重新分配:
if (shapeChanged) {
    graph->remallocForCurrentShapes();
    graph->validateMemory();
}
最后执行完整的计算图得到最终的结果。
Tensor Shape 更新
首先根据setShape()更新Shape和_size:
void TensorObj::setShape(Shape shape_) {
    const auto size = getTensorSize(shape_, dtype);

    if (shape == shape_)
        return;

    shape = std::move(shape_);
    _size = size;
    notifyCaptureState(false);
}
虽然设置了Shape,但是没有申请新的内存等等操作,所以需要重新进行inferShape,并且重新规划内存,最后执行Kernel。这后面就重复执行上一节的动态Shape执行流程即可
动态内存处理
这一块在动态Shape中也已经阐述,在动态Reshape输出发生变化后,根据之前选择的分配模式重新分配:
if (shapeChanged) {
    graph->remallocForCurrentShapes();
    graph->validateMemory();
}
这里进一步,分配模式时怎么来的:
enum class AllocationMode {
    Uninitialized,
    Naive,
    DynamicPool,
    FixedPool,
};
在第一次调用dataMalloc()时,Graph通过lockAllocationMode() 记录分配模式。remallocForCurrentShapes() 如下:
void GraphObj::remallocForCurrentShapes() {
    switch (allocationMode) {
    case AllocationMode::Uninitialized:
        dataMalloc(false, 0);
        break;
    case AllocationMode::Naive:
        dataMalloc(true, 0);
        break;
    case AllocationMode::DynamicPool:
        dataMalloc(false, 0);
        break;
    case AllocationMode::FixedPool:
        dataMalloc(false, 0);
        break;
    }
}
它根据第一次分配时记录的模式重新调用内存规划。Naive 模式下,每个 Tensor 单独管理自己的 Blob 。
与现有静态执行流程的兼容方式。
虽然我们增加了动态维度,但是对于静态输入,在经过处理后仍然时原来的整数Shape,传入C++和之前是一样的,所以不影响。
在模型导入时会判断输入中是否存在动态维度,如果所有维度都是固定了,那么仍然执行原有的ONNX simplifier流程。如果模型包含符号或者未知的维度,那么就会跳过simplifier,以避免动态Shape信息或者Shape子图被错误折叠。
对于Reshape(data, shape) 来说,如果shape来自initializer或Constant,那么前端继续调用原来的接口。如果来自运行时的Shape子图,那么构造动态ReshapeObj,相当于我们设计了两个构造函数。并且在ReshapeObj内部增加bool runtimeShape 以区分两种行为。而且通过这个,在Shape子图准备流程时不进入流程,只有动态Reshape才会触发新增流程。最后,我们复用了原有 Tensor、Blob 和 allocator,Shape 变化时重新运行同一套内存规划
结果展示
算子测试结果
Gather
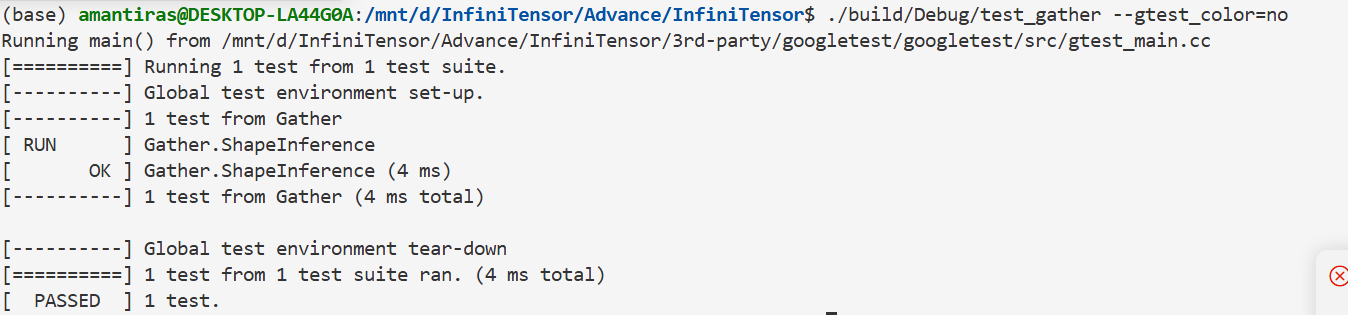
验证内容:Int32/Int64 indices,输出 Shape 推导
Concat
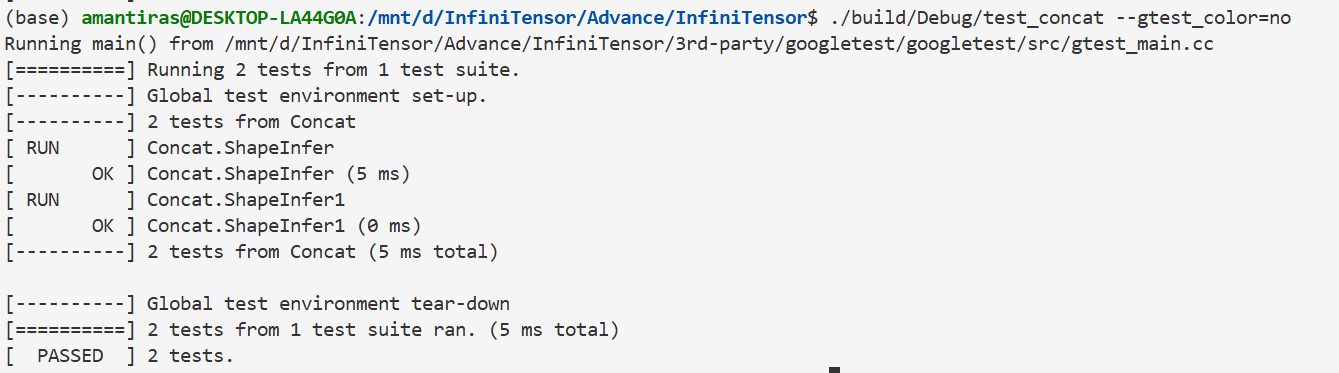
验证普通输入的拼接 Shape和包含空 Tensor 时的 Shape
Cast
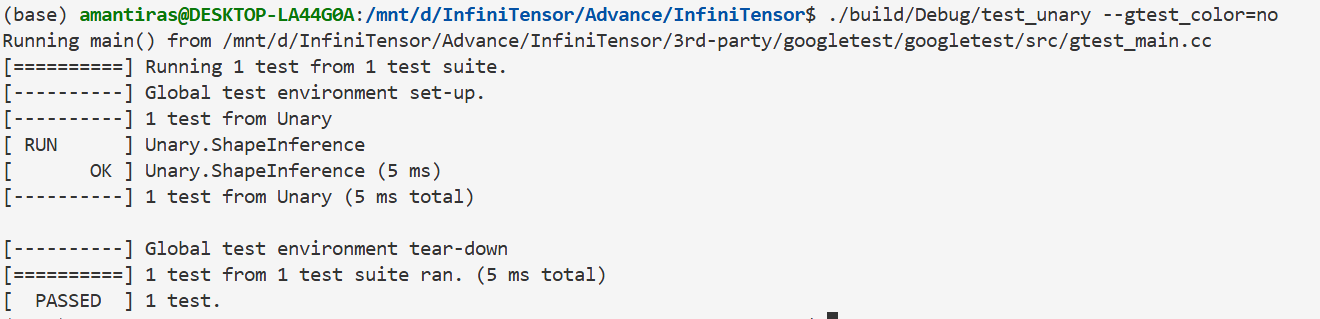
验证输出 Shape 和目标 dtype
Reshape | Squeeze | Unsqueeze
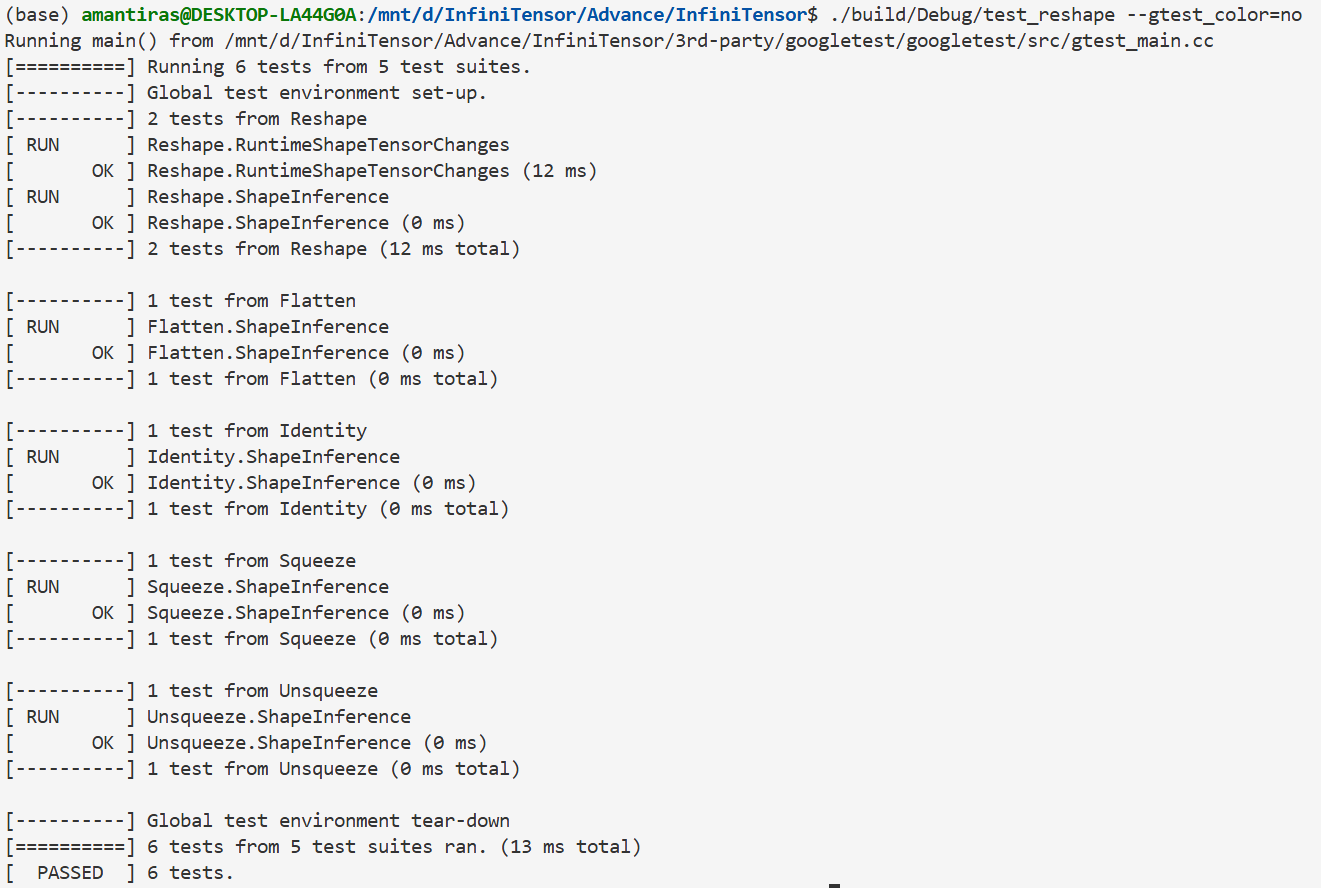
验证静态 Reshape Shape 推导,动态Reshape运行时 Shape Tensor 和数据结果,Squeeze、Unsqueeze的正轴、负轴及空 axes。
这个也是我新增的测试,用来验证动态Reshape能够正确更新Shape。
Concat CPU Kernel
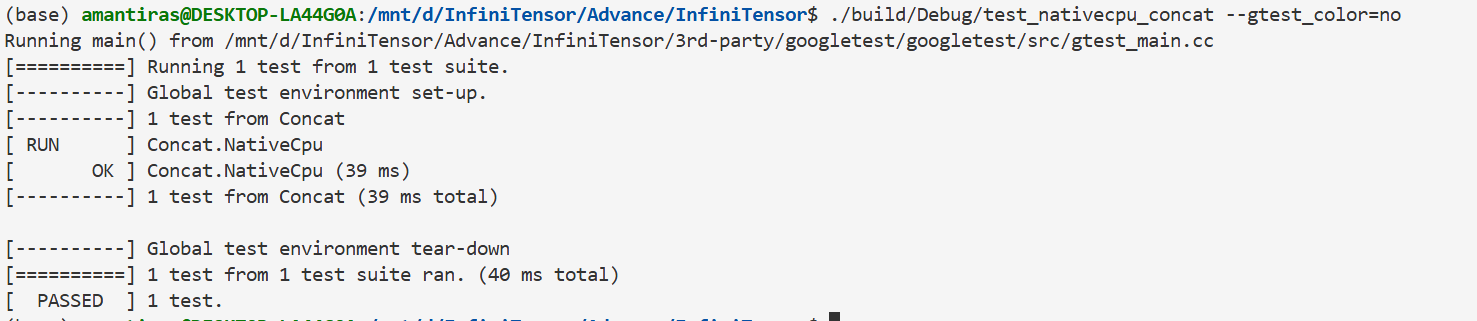
验证了Native CPU 数值计算。
完整Shape Tensor子图测试
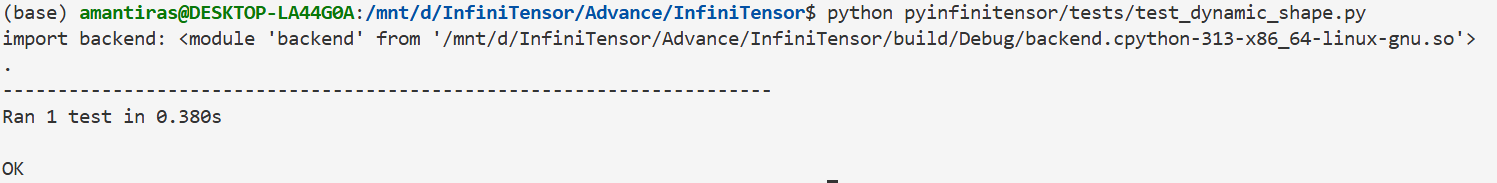
模型结构是:
X[batch,2,3]
   │
   ├── Shape ──→ [batch,2,3]
   │                 │
   │               Gather(index=0)
   │                 │
   │                 batch
   │                 │
   │              Unsqueeze
   │                 │
   │               [batch] ──────┐
   │                             │
   │        Int32[6] → Cast → [6]│
   │                             ↓
   │                          Concat
   │                             │
   │                         [batch,6]
   │                             │
   └───────────────────────── Reshape
                                 │
                             [batch,6]
                                 │
                            Add(bias)
                                 │
                             Y[batch,6]
测试模型通过 Shape → Gather → Unsqueeze → Cast → Concat 动态构造 Reshape 的第二输入。以 batch=8 为例,Shape 算子产生 [8,2,3],Gather 提取 batch 值 8,Unsqueeze 将标量转换为一维 Tensor,随后与 Cast 后的常量 [6] 拼接,得到目标 Shape Tensor [8,6]。动态 Reshape 读取该 Tensor 后将输出 Shape 更新为 [8,6]。完整 Shape 子图测试在默认 DynamicPool 和 naive allocator 下均通过。
这里设计的关键代码如下,我们没有重新加载模型,而是连续的输入不同的shape:
stub = OnnxStub(
    model,
    backend.cpu_runtime(),
    use_naive_allocator=naive,
)

for batch in (1, 2, 8, 3, 1):
    x = rng.standard_normal(
        (batch, 2, 3)
    ).astype(np.float32)

    stub.set_input([list(x.shape)])
    stub.inputs["x"].copyin_numpy(x)
    stub.run()
ONNX前端和输入验证测试
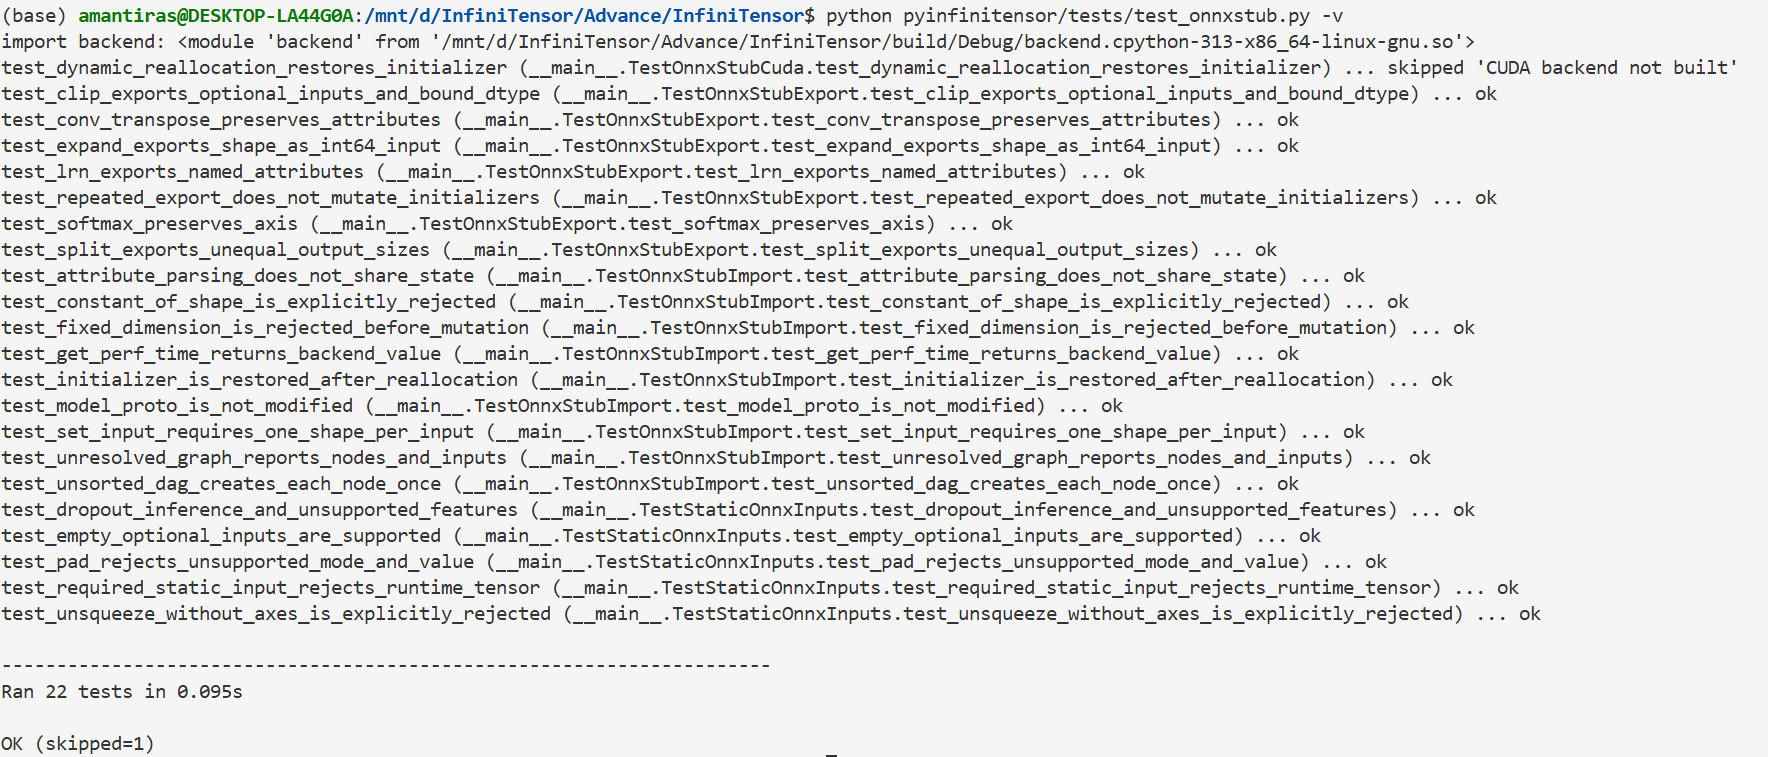
21 项通过,1 项 CUDA 测试因当前构建未启用 CUDA 而跳过。这个是原本就存在的测试,我把输入从[1, 2]换成了[”batch”, 2]验证了效果
InfiniTensor 与 ONNX Runtime 的输出 Shape 和数值对比。
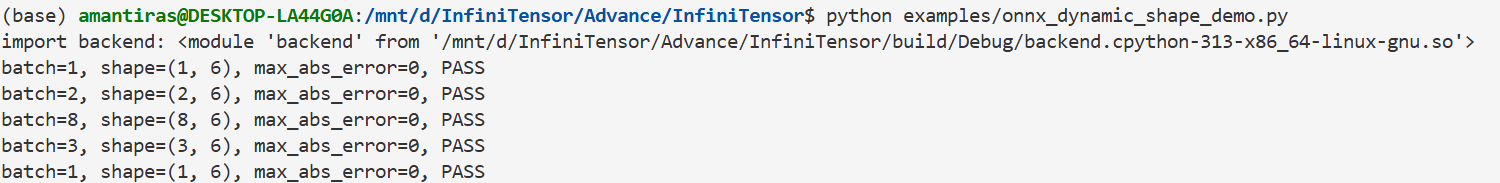
内部关键代码执行的是:
expected = reference.run(
    ["y"],
    {"x": x},
)[0]

actual_shape = tuple(
    stub.getShape("y")
)

if actual_shape != expected.shape:
    raise AssertionError(
        f"Shape mismatch: "
        f"InfiniTensor={actual_shape}, "
        f"ORT={expected.shape}"
    )

actual = np.asarray(
    stub.outputs["y"].copyout_float(),
    dtype=np.float32,
).reshape(actual_shape)

np.testing.assert_allclose(
    actual,
    expected,
    rtol=1e-4,
    atol=1e-5,
)
符合预期
使用说明
ONNX 模型准备方式;
我以/InfiniTensor/examples/onnx_dynamic_shape_demo.py 为例:
首先设计函数,把NumPy数组转换为 ONNX initializer。
def const(name, value, dtype):
    return numpy_helper.from_array(
        np.asarray(value, dtype=dtype),
        name,
    )
然后创建Shape算子:
nodes = [
        helper.make_node("Shape", ["x"], ["x_shape"]),
        helper.make_node("Gather", ["x_shape", "index"], ["batch_scalar"], axis=0),
        helper.make_node("Unsqueeze", ["batch_scalar", "axes"], ["batch_vector"]),
        helper.make_node("Cast", ["six_i32"], ["six_i64"], to=TensorProto.INT64),
        helper.make_node("Concat", ["batch_vector", "six_i64"], ["target"], axis=0),
        helper.make_node("Reshape", ["x", "target"], ["flat"]),
        helper.make_node("Add", ["flat", "bias"], ["y"]),
    ]
创建图:
graph = helper.make_graph(
        nodes,
        "runtime_shape_demo",
        [helper.make_tensor_value_info("x", TensorProto.FLOAT, ["batch", 2, 3])],
        [helper.make_tensor_value_info("y", TensorProto.FLOAT, ["batch", 6])],
        initializer=[
            const("index", 0, np.int64),
            const("axes", [0], np.int64),
            const("six_i32", [6], np.int32),
            const("bias", [0.25, -1.0, 2.0, 0.5, -0.5, 3.0], np.float32),
        ],
        value_info=[
            helper.make_tensor_value_info("flat", TensorProto.FLOAT, ["batch", 6])
        ],
    )
make_graph参数依次是:
nodes:图中的算子
name:图名称
inputs:模型输入
outputs:模型输出
initializer:常量和权重
value_info:中间 Tensor 的类型和 Shape 声明
创建ONNX Model:
model = helper.make_model(
    graph,
    opset_imports=[
        helper.make_opsetid("", 18)
    ],
    ir_version=8,
)
然后执行得到model后,创建ModelProto :
stub = OnnxStub(
    model,
    backend.cpu_runtime(),
    use_naive_allocator=naive,
)
然后就可以执行相关操作了
stub.set_input([list(x.shape)])
stub.inputs["x"].copyin_numpy(x)
stub.run()
demon启动方式
这里我的环境是CMake 3.17及以上,Python 3.10
进入目录:
cd /InfiniTensor
执行Make配置:
make
make install-python
运行单元测试
make test-cpp
运行python程序测试:
make test-onnx
运行我们设计的实验:
InfiniTensor 与 ONNX Runtime 的输出 Shape 和数值对比和完整Shape Tensor子图测试
python examples/onnx_dynamic_shape_demo.py
python pyinfinitensor/tests/test_dynamic_shape.py -v
动态输入设置范围
ONNX 模型中的动态维度只描述“哪些维度可以变化”,真正执行模型时仍然需要为每个输入提供确定的 Shape。例如,模型输入声明为:
X: ["batch", 2, 3]
其中 batch 是动态维度,2 和 3 是固定维度。实际运行时,可以分别设置为:
[1, 2, 3]
[2, 2, 3]
[8, 2, 3]
但不能设置为 [2, 4, 3],因为第二个维度是固定值 2。
当前支持范围
1. ONNX 动态维度表示
目前支持导入以下三类 ONNX 输入维度:
| 维度类型 | ONNX 表示示例 | 含义 |
|---|---|---|
| 固定维度 | [1, 3, 224, 224] 中的 3 |
执行时不能改变 |
| 符号维度 | ["batch", 3, 224, 224] 中的 "batch" |
执行时允许设置为不同非负整数 |
| 未知维度 | ONNX 中既没有 dim_value 也没有 dim_param |
执行时允许设置具体值 |
Python 导入层保留原始维度类型,不会在首次导入时把动态维度永久替换为固定值。
2. 连续动态输入
支持同一个 OnnxStub 实例连续处理多个不同的合法输入 Shape:
batch=1 → batch=2 → batch=8 → batch=3 → batch=1
不需要为每个 Shape 重新读取或重新导入 ONNX 模型。
输入 Rank 当前应保持不变,变化的是各个动态轴的具体长度。
3. Shape Tensor 数据类型
运行时 Shape Tensor 当前要求:
- Tensor 为一维 Tensor;
- 数据类型为
Int64; - Tensor 数据在执行动态
Reshape前已经计算完成; - Shape Tensor 的元素个数决定输出 Rank,当前运行过程中该 Rank不能变化。
例如:
shape_tensor = [batch, 6]
是合法的运行时 Shape Tensor。
4. Shape Tensor 相关算子
当前 Shape 子图支持以下基础算子:
| 算子 | 在 Shape 子图中的作用 |
|---|---|
Shape |
获取输入 Tensor 的当前 Shape |
Gather |
从 Shape Tensor 中选取指定维度 |
Unsqueeze |
为标量或低 Rank Shape Tensor增加维度 |
Squeeze |
删除长度为 1 的维度 |
Concat |
拼接多个 Shape 片段 |
Cast |
转换 Shape Tensor 的数据类型 |
Identity |
直接传递 Shape Tensor |
5. 动态 Shape 算子
当前重点支持由运行时 Shape Tensor 驱动的 Reshape:
Reshape(data, shape_tensor)
支持的 Reshape Shape 规格包括:
- 普通正整数维度,例如
[2, 6]; 1自动推导维度;0按 ONNXallowzero规则处理;- 检查输入、输出元素数量是否一致;
- 检查多个
1、越界维度和无法整除等非法情况。
原有的静态属性式 Reshape 路径仍然保留。
6. Shape 更新与内存管理
支持以下内存方式:
- Naive allocator;
- Dynamic pool allocator。
动态内存池可以复用已有容量;当新 Shape 所需空间超过当前容量时,会重新规划和分配内存。
已知限制及常见错误处理。
已知限制
目前仅支持CPU后端,不支持CUDA、BANG、Kunlun等后端。
当前支持改变动态轴的具体长度,但不支持改变输入 Tensor 的 Rank。
动态输入设置只允许改变 dim_param 或未知维度。ONNX 中通过 dim_value 声明的固定维度必须保持不变。
Shape Tensor 必须是一维 Int64 Tensor
Shape子图只支持部分算子:
Shape
Gather
Unsqueeze
Squeeze
Concat
Cast
Identity
动态模型不会经过ONNX simplifier
常见错误处理
错误示例:
# 模型有一个输入,但没有提供任何 Shape
stub.set_input([])
错误信息:
inputShapes must contain one shape per model input; expected 1, got 0
原因:set_input() 要求为每个模型输入提供一个 Shape。
处理方式:
stub.set_input([[2, 2, 3]])
错误示例:
stub.set_input([[2.0, 2, 3]])
可能得到:
Input X, axis 0: dimension must be an integer
处理方式:使用 Python 整数或支持整数协议的 NumPy 整数:
stub.set_input([[2, 2, 3]])
不要用浮点数、字符串或 None 作为实际执行 Shape。
可能出现:
ModuleNotFoundError: No module named 'backend'
或者加载了旧版本:
import backend: .../backend.cpython-xxx.so
但该文件不是本次编译生成的版本。
处理方式:
export PYTHONPATH="$PWD/build/cpu-debug:$PWD/pyinfinitensor/src:$PYTHONPATH"
python3 -c "from pyinfinitensor import backend; print(backend.__file__)"
确认输出路径指向当前项目对应的 .so 文件。修改 C++ 后,需要重新编译:
cmake --build build/cpu-debug -j
如果 Python 直接从 pyinfinitensor/src/pyinfinitensor 加载扩展,则应确认该目录中的扩展模块已由当前代码重新构建。
测试中可能出现:
ONNX Runtime only guarantees support for models stamped with
official released ONNX opset versions
例如当前 ONNX Runtime正式支持到 opset 26,而测试模型被标记为开发中的 opset 27。
如果测试最终显示:
Ran 58 tests
OK
则中间信息只是 onnxsim 尝试执行自定义算子时产生的警告,并非测试失败。
自行创建模型时,建议显式指定稳定 opset:
model = helper.make_model(
    graph,
    opset_imports=[helper.make_opsetid("", 18)],
)