从零速通CUDA,最后希望能自己完成FlashAttention的编写
前置知识
我们以GPU上的加法为例去阐述整个流程:
准备和初始化数据(CPU)
const size_t SIZE = 1 << 20;
size_t size_bytes = SIZE * sizeof(float);

std::vector<float> h_a(SIZE, 1);
std::vector<float> h_b(SIZE, 2);
std::vector<float> h_c(SIZE, 0);

float *d_a, *d_b, *d_c;
CUDA_CHECK(cudaMalloc(&d_a, size_bytes));
CUDA_CHECK(cudaMalloc(&d_b, size_bytes));
CUDA_CHECK(cudaMalloc(&d_c, size_bytes));
数据传输到GPU
CUDA_CHECK(cudaMemcpy(d_a, h_a.data(), size_bytes, cudaMemcpyHostToDevice));
CUDA_CHECK(cudaMemcpy(d_b, h_b.data(), size_bytes, cudaMemcpyHostToDevice));
CUDA_CHECK(cudaMemcpy(d_c, h_c.data(), size_bytes, cudaMemcpyHostToDevice));
GPU从GM中读取并计算后写回(调用函数计算)
线程的层级结构:
- SIMT -> 指挥每个线程 -> 需要组织结构和编号
- CUDA的方式: Grid->Block->Thread
- idx = BlockID * BLOCK Size + Thread ID
在此背景下,我们需要定义block的数量和大小来指挥线程同时进行/并行计算,定义GPU上的加法函数,结合定义的信息调用GPU加法函数
dim3 block_dim(256)
dim3 grid_dim((SIZE + block_dim.x - 1) / block_dim.x)
add_kernel<<<grid_dim, block_dim>>>(d_c, d_a, d_b, SIZE);
template<typename T>
__global__ add_kernel(T *c, const T *a, const T *b, int n) {
  int idx = blockIdx.x * blockDim.x + threadIdx.x;
  if (idx < n){
    c[idx] = a[idx] + b[idx];
  }
}
这里阐述一下相关定义:
- dim3: CUDA表示线程层级结构的类型
- <<<>>>: 传递线程层级信息给核函数
- 核函数: 设备侧的入口函数
- __global__: 表示这是个核函数
- blockIdx: block编号
- blockDim:block大小
- threadIdx:thread的编号
将GPU数据传输回CPU
CUDA_CHECK(cudaMemcpy(h_c.data(), d_c, size_bytes, cudaMemcpyDeviceToHost));
运行程序验证结果,释放内存
if(d_a) CUDA_CHECK(cudaFree(d_a));
if(d_b) CUDA_CHECK(cudaFree(d_b));
if(d_c) CUDA_CHECK(cudaFree(d_c));
#define CUDA_CHECK(call){
  cudaError_t = err = call;
  if (err !- cudaSuccess){
    std::cerr << "CUDA error at " << __FILE__ << ":" << __LINE__ << " = "<< cudaGetErrorString(err) << "\n";
    exit(1) ;
  }
}
这里额外记录一下:
- __global__ 代表在CPU端调用,在GPU执行,不能有返回值
- __device__ 在GPU端调用执行
- __host__ 在CPU端调用执行
环境
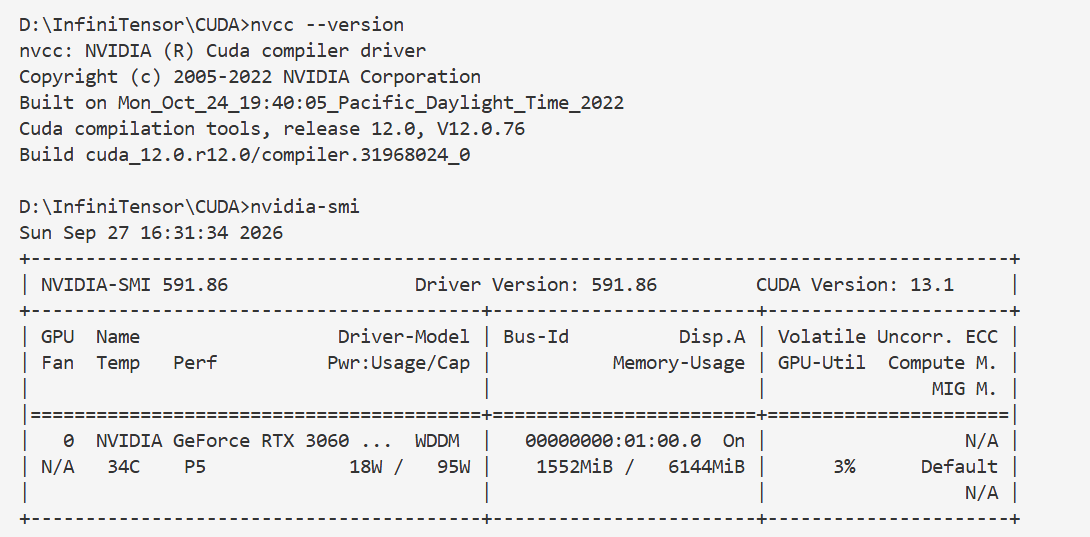
nvidia-smi 的 CUDA Version 与 nvcc --version 可以不同?”前者反映驱动支持的 CUDA 版本能力,后者反映当前调用的 Toolkit 编译器版本。
输出相关环境:
#include <cuda_runtime.h>
#include <cstdlib>
#include <iomanip>
#include <iostream>

// 检查 CUDA Runtime API 是否执行成功
void checkCuda(cudaError_t error, const char* operation) {
    if (error != cudaSuccess) {
        std::cerr << "CUDA error while " << operation << ": "
                  << cudaGetErrorString(error) << '\n';
        std::exit(EXIT_FAILURE);
    }
}

int main () {
    int count = 0;
    checkCuda(
        cudaGetDeviceCount(&count),
        "getting device count"
    );
    std::cout << "CUDA device count: " << count << "\n\n";
    // 遍历每一张 GPU
    for (int device = 0; device < count; ++device) {
        cudaDeviceProp prop{};

        checkCuda(
            cudaGetDeviceProperties(&prop, device),
            "getting device properties"
        );

        double memoryGiB =
            static_cast<double>(prop.totalGlobalMem)
            / (1024.0 * 1024.0 * 1024.0);

        std::cout << "Device " << device << '\n';
        std::cout << "----------------------------------------\n";

        std::cout << "Name: "
                  << prop.name << '\n';

        std::cout << "Compute capability: "
                  << prop.major << '.'
                  << prop.minor << '\n';

        std::cout << "SM count: "
                  << prop.multiProcessorCount << '\n';

        std::cout << "Warp size: "
                  << prop.warpSize << '\n';

        std::cout << "Maximum threads per block: "
                  << prop.maxThreadsPerBlock << '\n';

        std::cout << "Maximum block dimensions: "
                  << prop.maxThreadsDim[0] << " x "
                  << prop.maxThreadsDim[1] << " x "
                  << prop.maxThreadsDim[2] << '\n';

        std::cout << "Maximum grid dimensions: "
                  << prop.maxGridSize[0] << " x "
                  << prop.maxGridSize[1] << " x "
                  << prop.maxGridSize[2] << '\n';

        std::cout << "Shared memory per block: "
                  << prop.sharedMemPerBlock
                  << " bytes\n";

        std::cout << "Total global memory: "
                  << prop.totalGlobalMem
                  << " bytes ("
                  << std::fixed << std::setprecision(2)
                  << memoryGiB << " GiB)\n\n";
    }

    return EXIT_SUCCESS;
}
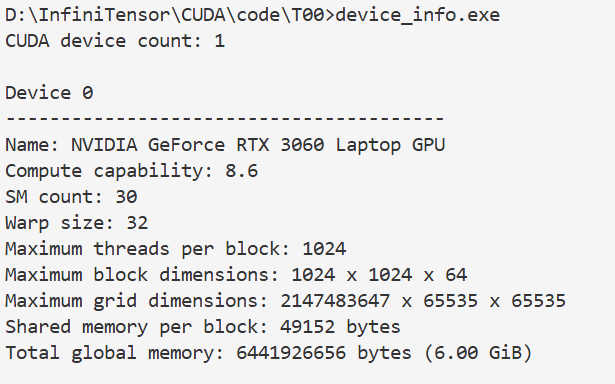
输出文件:
驱动、Toolkit、主机编译器、GPU 架构四者的区别:
驱动:操作系统与NVIDIA GPU之间的控制软件 nvidia-smi
CUDA Toolkit: CUDA开发工具包 nvcc
主机编译器: 负责 CUDA 程序中 CPU 部分的 C++ 编译器
GPU架构: GPU 本身采用的硬件设计代际。
这里注意maxThreadsDim不代表可以取这个值,因为 maxThreadsDim 只表示 block 在每个方向上的单独上限,同时还必须满足 block 的总线程数上限 maxThreadsPerBlock。
加法完整代码:
#include <iostream>
#include <iomanip>
#include <vector>
#include <cmath>

#define CUDA_CHECK(call) { \
    cudaError_t err = call ;   \
    if (err != cudaSuccess){ \
        std::cerr << "CUDA error at " << __FILE__ << ":" << __LINE__ << ": " \
                  << cudaGetErrorString(err) << '\n'; \
        exit(1); \
    }    \
} \


template <typename T>
__global__ void add_kernel(T *c, const T *a, const T *b, size_t n) {
    size_t idx = (blockDim.x) * blockIdx.x + threadIdx.x;
    if (idx < n) {
        c[idx] = a[idx] + b[idx] ;
    }
}

void free_device_memory(float *d_a, float *d_b, float *d_c) {
    if(d_a) CUDA_CHECK(cudaFree(d_a));
    if(d_b) CUDA_CHECK(cudaFree(d_b));
    if(d_c) CUDA_CHECK(cudaFree(d_c));
}

int main () {
    const size_t SIZE = 1 << 20 ;

    std::vector<float> h_a(SIZE, 1) ;
    std::vector<float> h_b(SIZE, 2);
    std::vector<float> h_c(SIZE, 0);

    float *d_a, *d_b, *d_c;

    size_t size_bytes = SIZE * sizeof(float);

    CUDA_CHECK(cudaMalloc(&d_a, size_bytes));
    CUDA_CHECK(cudaMalloc(&d_b, size_bytes));
    CUDA_CHECK(cudaMalloc(&d_c, size_bytes));

    CUDA_CHECK(cudaMemcpy(d_a, h_a.data(), size_bytes, cudaMemcpyHostToDevice));
    CUDA_CHECK(cudaMemcpy(d_b, h_b.data(), size_bytes, cudaMemcpyHostToDevice));
    CUDA_CHECK(cudaMemcpy(d_c, h_c.data(), size_bytes, cudaMemcpyHostToDevice));

    dim3 block_dim(std::min(static_cast<int>(SIZE), 256));
    dim3 grid_dim((SIZE + block_dim.x - 1) / block_dim.x) ;


    add_kernel<<<grid_dim,block_dim>>>(d_c, d_a, d_b, SIZE);

    CUDA_CHECK(cudaMemcpy(h_c.data(), d_c, size_bytes, cudaMemcpyDeviceToHost));

    for (size_t i = 0; i < SIZE; i ++) {
        if (fabs(h_c[i] - 3.0f) > 1e-5){
            std::cerr <<  "Verification failed at index " << i << ": "
                        << h_c[i] << " != 3.0\n";
            break;
        }
    }

    free_device_memory(d_a, d_b, d_c);
    d_a = d_b = d_c = nullptr;
    printf("passed!\n");
    return 0 ;
}
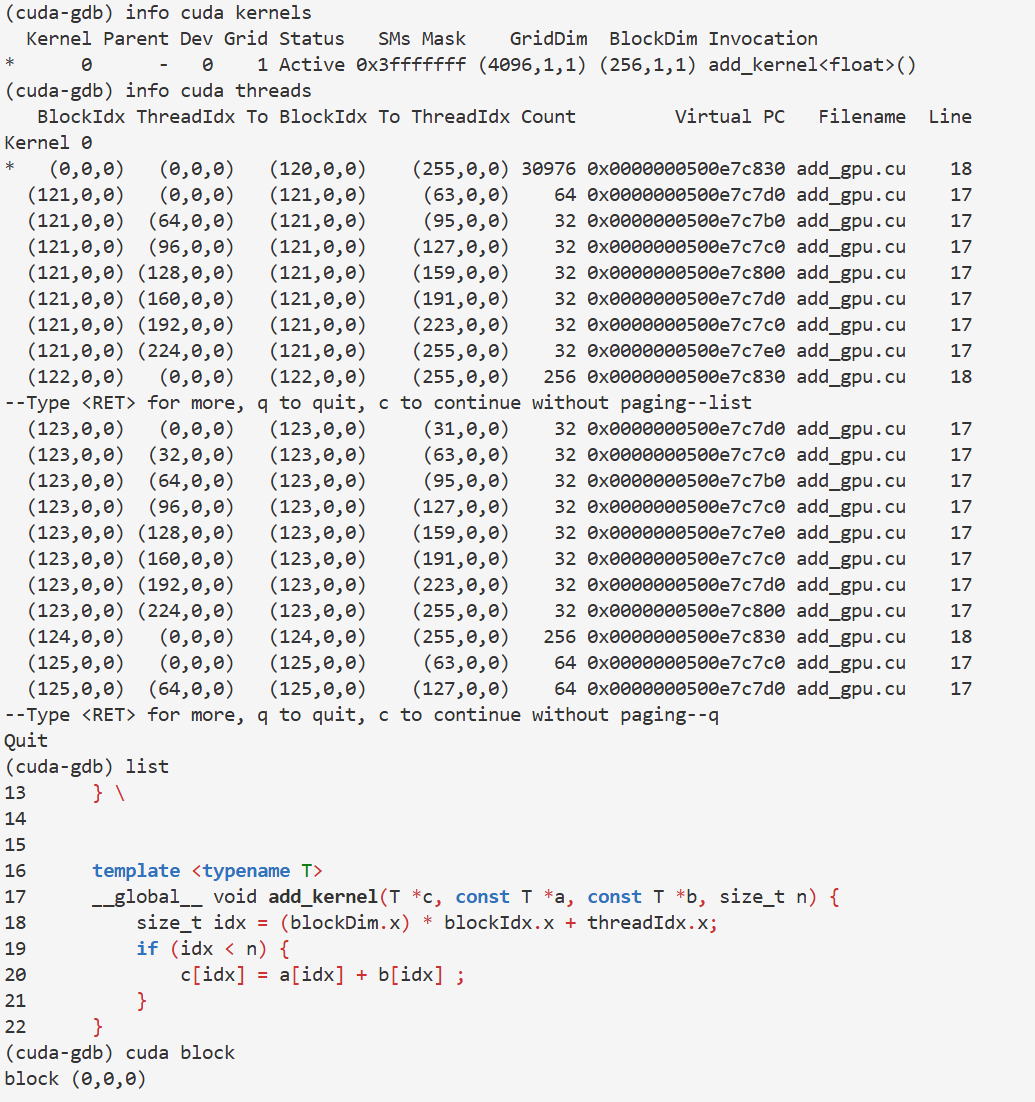
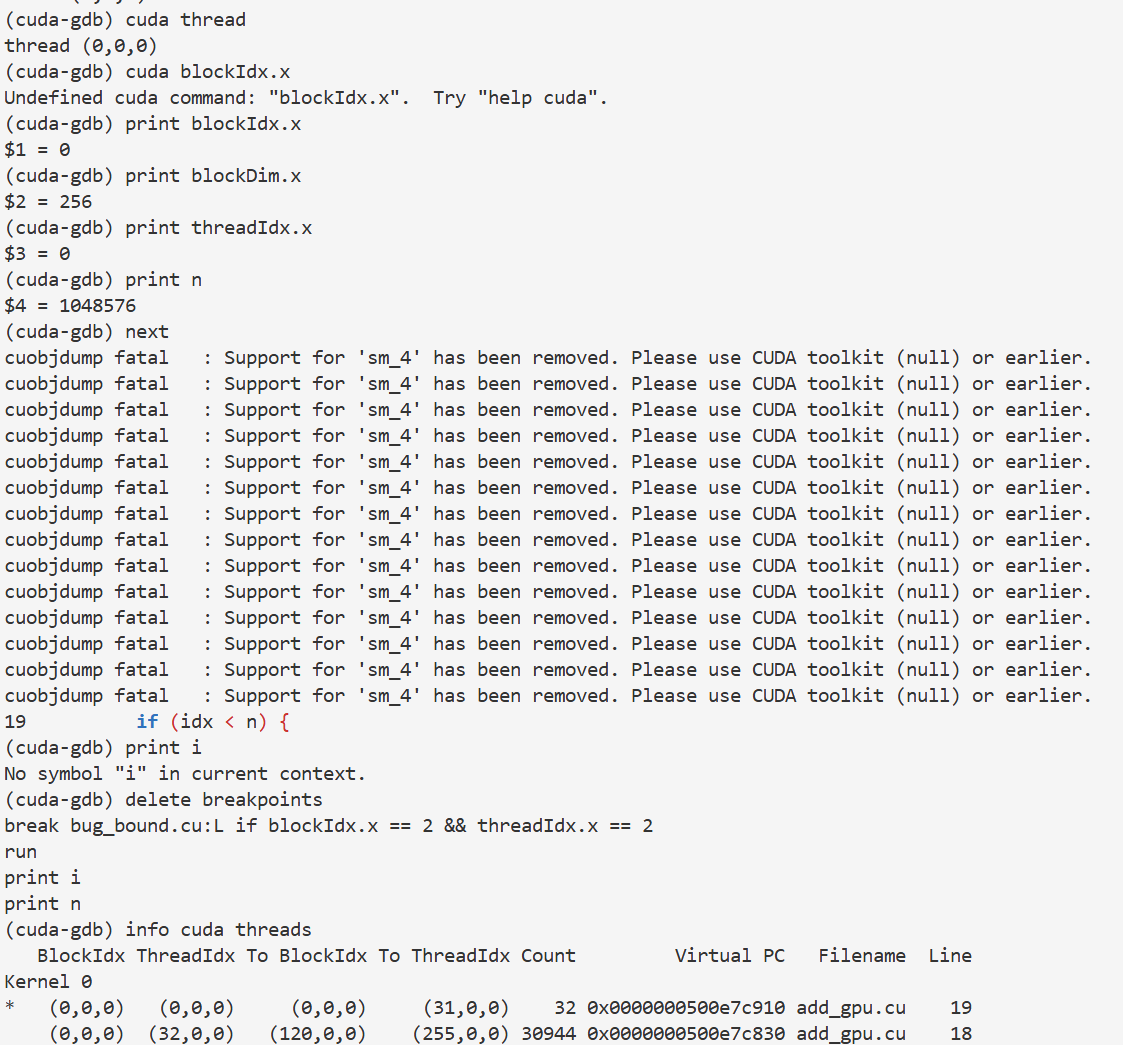
调试:
grid_stride版本:
template <typename T>
__global__ void add_grid_stride(
    T* c,
    const T* a,
    const T* b,
    size_t n
) {
    size_t first =
        static_cast<size_t>(blockIdx.x) * blockDim.x
        + threadIdx.x;

    size_t stride =
        static_cast<size_t>(blockDim.x) * gridDim.x;

    for (size_t i = first; i < n; i += stride) {
        c[i] = a[i] + b[i];
    }
}
这个我懒得验证了
今天先这样