参考知乎猛猿的文章(https://zhuanlan.zhihu.com/p/669926191),以及自己之后对于FlashAttention的代码书写笔记都会放在这里。
Flash attenion在做一件什么事
对于Transformer模型,假设其输入序列长度为$N$,那么其计算复杂度和消耗的存储空间都为$O(N^2)$。
因此,我们迫切需要一种办法,能解决Transformer模型的 $O(N^2)$复杂度问题。如果能降到$O(N)$ ,那是最好的,即使做不到,逼近$O(N)$ 那也是可以的。所以,Flash Attention就作为一种行之有效的解决方案出现了。
Flash Attention在做的事情,其实都包含在它的命名中了(Fast and Memory Efficient Exact Attention with IO-Awareness),我们逐一来看:
-
Fast(with IO-Awareness),计算快。在Flash Attention之前,也出现过一些加速Transformer计算的方法,这些方法的着眼点是“减少计算量FLOPs”,例如用一个稀疏attention做近似计算。但是Flash attention就不一样了,它并没有减少总的计算量,因为它发现:计算慢的卡点不在运算能力,而是在读写速度上。所以它通过降低对显存(HBM)的访问次数来加快整体运算速度,这种方法又被称为O-Awareness。在后文中,我们会详细来看Flash Attention是如何通过分块计算(tiling)和核函数融合(kernel fusion)来降低对显存的访问。
-
Memory Efficicent,节省显存。在标准attention场景中,forward时我们会计算并保存N*N大小的注意力矩阵;在backward时我们又会读取它做梯度计算,这就给硬件造成了$O(N^2)$ 的存储压力。在Flash Attention中,则巧妙避开了这点,使得存储压力降至$O(N)$ 。在后文中我们会详细看这个trick。
-
Exact Attention,精准注意力。在(1)中我们说过,之前的办法会采用类似于“稀疏attention”的方法做近似。这样虽然能减少计算量,但算出来的结果并不完全等同于标准attention下的结果。但是Flash Attention却做到了完全等同于标准attention的实现方式,这也是后文我们讲述的要点。
计算限制与内存限制
在第一部分中我们提过,Flash Attention一个很重要的改进点是:由于它发现Transformer的计算瓶颈不在运算能力,而在读写速度上。因此它着手降低了对显存数据的访问次数,这才把整体计算效率提了上来
先看几个概念:
- $\pi$:硬件算力上限。指的是一个计算平台倾尽全力每秒钟所能完成的浮点运算数。单位是 FLOPS or FLOP/s。
- $\beta$:硬件带宽上限。指的是一个计算平台倾尽全力每秒所能完成的内存交换量。单位是Byte/s。
- $\pi_t$:某个算法所需的总运算量,单位是FLOPs。下标 $t$ 表示total。
- $\beta_t$ :某个算法所需的总数据读取存储量,单位是Byte。下标$t$表示total。
在执行运算的过程中,时间不仅花在计算本身上,也花在数据读取存储上,最终一个算法运行的总时间,取决于计算时间和数据读取时间中的最大值。
这里其实更应该用Roofline的这个思想去做阐述,也就是说这个算法优化的点在于这个是个读取密集的算法,所以我们需要对它进行算子融合等操作去优化它的计算量。这里看我写的CUDA的文章会更清楚一点。
Attention计算中的计算与内存限制
现在我们可以来分析影响Transformer计算效率的因素到底是什么了。我们把目光聚焦到attention矩阵的计算上,其计算复杂度为$O(N^2)$,是Transformer计算耗时的大头。
假设我们现在采用的硬件为A100-40GB SXM,同时采用混合精度训练(可理解为训练过程中的计算和存储都是fp16形式的,一个元素占用2byte):$\frac{\pi}{\beta} = \frac{312*10^{12}}{155*10^{9}} = 201FLOPs/Bytes$
假定我们现在有矩阵$Q,K \in R^{N*d}$,其中$N$为序列长度,$d$为embedding dim。现在我们要计算$S=QK^T$,则有:$\frac{\pi_t}{\beta_t} = \frac{2N^2d}{2Nd+2Nd+2N^2} = \frac{N^2d}{2Nd+N^2}$
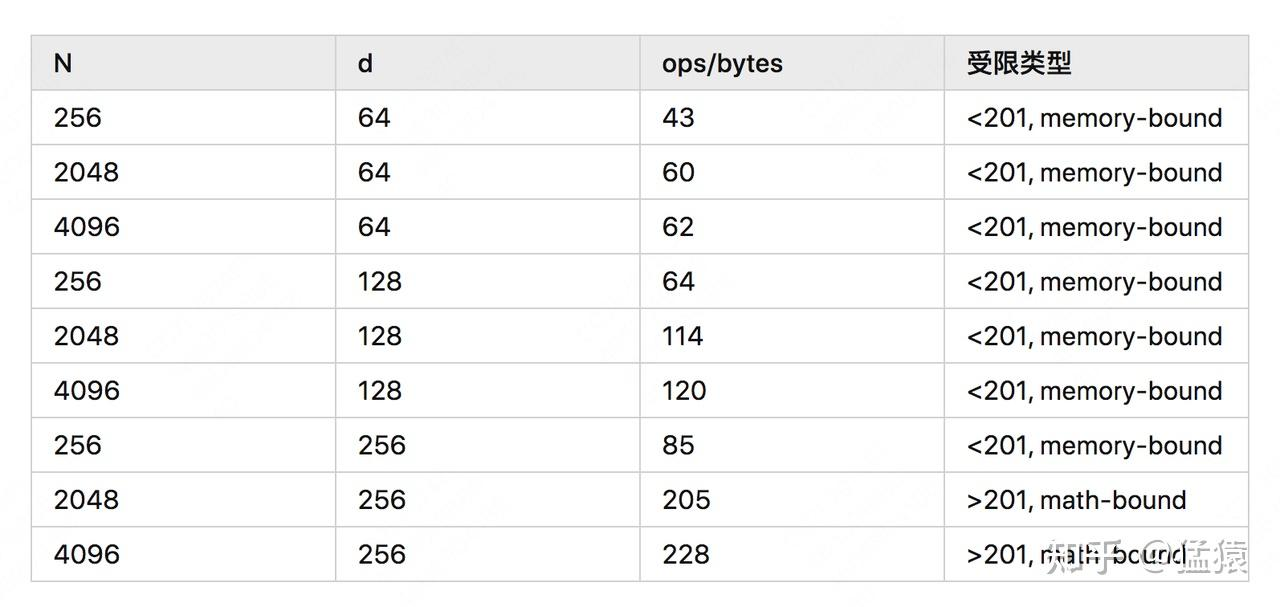
- 计算限制(math-bound):大矩阵乘法(N和d都非常大)、通道数很大的卷积运算。相对而言,读得快,算得慢。
- 内存限制(memory-bound):逐点运算操作。例如:激活函数、dropout、mask、softmax、BN和LN。相对而言,算得快,读得慢。
所以,我们第一部分中所说,“Transformer计算受限于数据读取”也不是绝对的,要综合硬件本身和模型大小来综合判断。但从表中的结果我们可知,memory-bound的情况还是普遍存在的,所以Flash attention的改进思想在很多场景下依然适用。
在Flash attention中,计算注意力矩阵时的softmax计算就受到了内存限制,这也是flash attention的重点优化对象,我们会在下文来详细看这一点。
Roofline
欸,这文章还真讲了Roofline,这里我就不赘述了,我的CUDA那边写的更详细一点。
GPU上的存储与计算
由于Flash attention的优化核心是减少数据读取的时间,而数据读取这块又离不开数据在硬件上的流转过程,所以这里我们简单介绍一些GPU上的存储与计算内容,作为Flash attention的背景知识。
GPU的存储分类
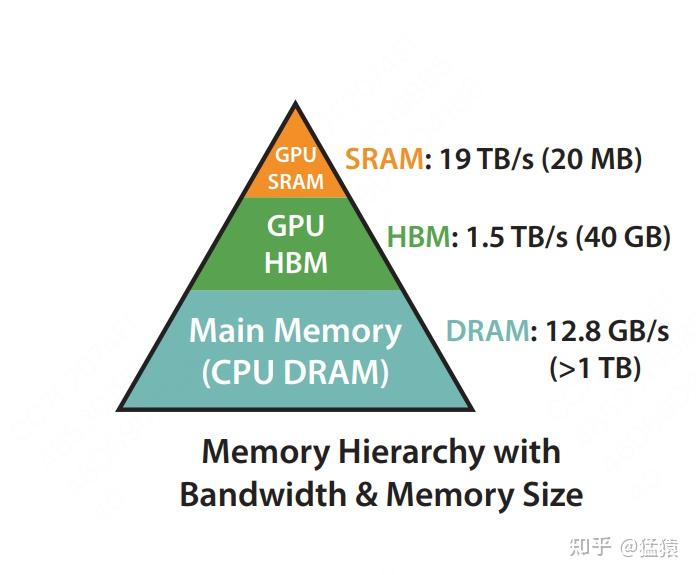
上图是Flash attention论文所绘制的硬件不同的存储类型、存储大小和带宽。一般来说,GPU上的存储分类,可以按照是否在芯片上分为片上内存(on chip)和片下内存(off chip)。
- 片上内存:主要用于缓存(cache)及少量特殊存储单元(例如texture),其特点是“存储空间小,但带宽大”。对应到上图中,SRAM就属于片上内存,它的存储空间只有20MB,但是带宽可以达到19TB/s。
- 片下内存:主要用于全局存储(global memory),即我们常说的显存,其特点是“存储空间大,但带宽小”,对应到上图中,HBM就属于片下内存(也就是显存),它的存储空间有40GB(A100 40GB),但带宽相比于SRAM就小得多,只有1.5TB/s。
当硬件开始计算时,会先从显存(HBM)中把数据加载到片上(SRAM),在片上进行计算,然后将计算结果再写回显存中。那么这个“片上”具体长什么样,它又是怎么计算数据的呢?
GPU是如何做计算的
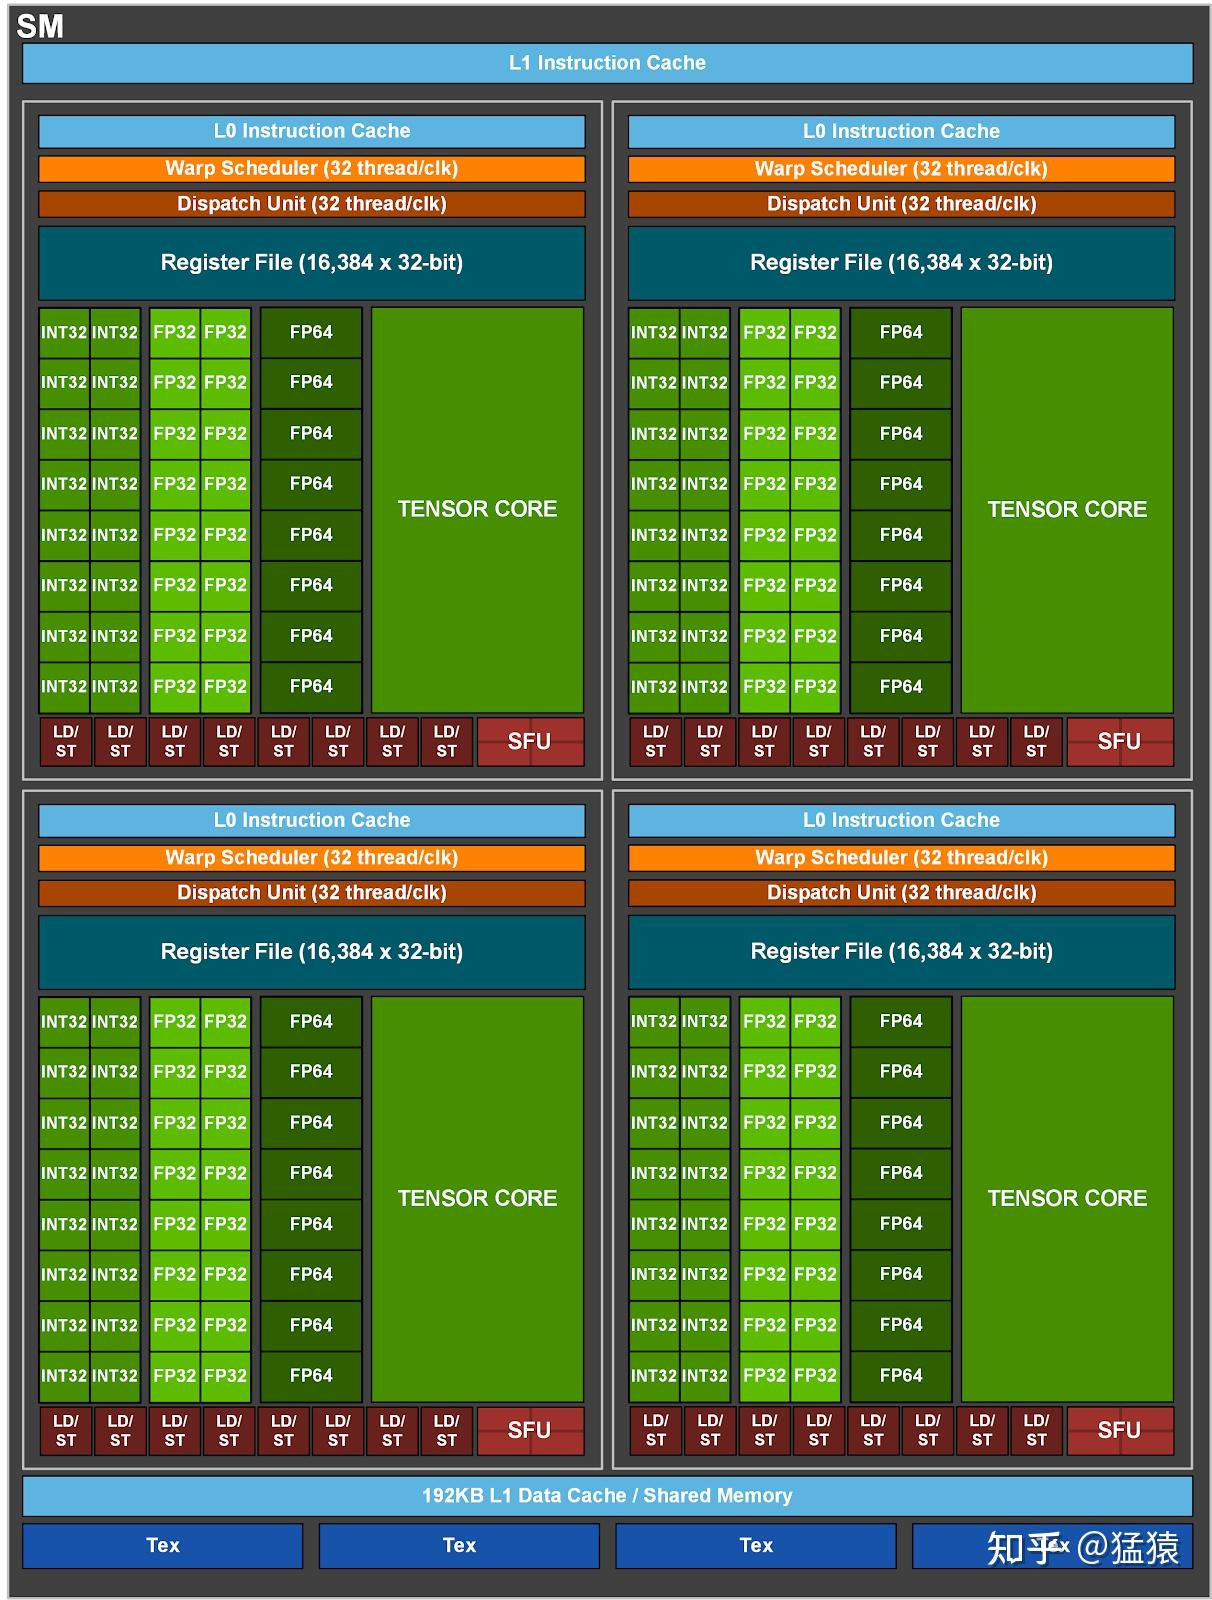
如图,负责GPU计算的一个核心组件叫SM(Streaming Multiprocessors,流式多处理器),可以将其理解成GPU的计算单元,一个SM又可以由若干个SMP(SM Partition)组成,例如图中就由4个SMP组成。SM就好比CPU中的一个核,但不同的是一个CPU核一般运行一个线程,但是一个SM却可以运行多个轻量级线程(由Warp Scheduler控制,一个Warp Scheduler会抓一束线程(32个)放入cuda core(图中绿色小块)中进行计算)。
现在,我们将GPU的计算核心SM及不同层级GPU存储结构综合起来,绘制一张简化图:
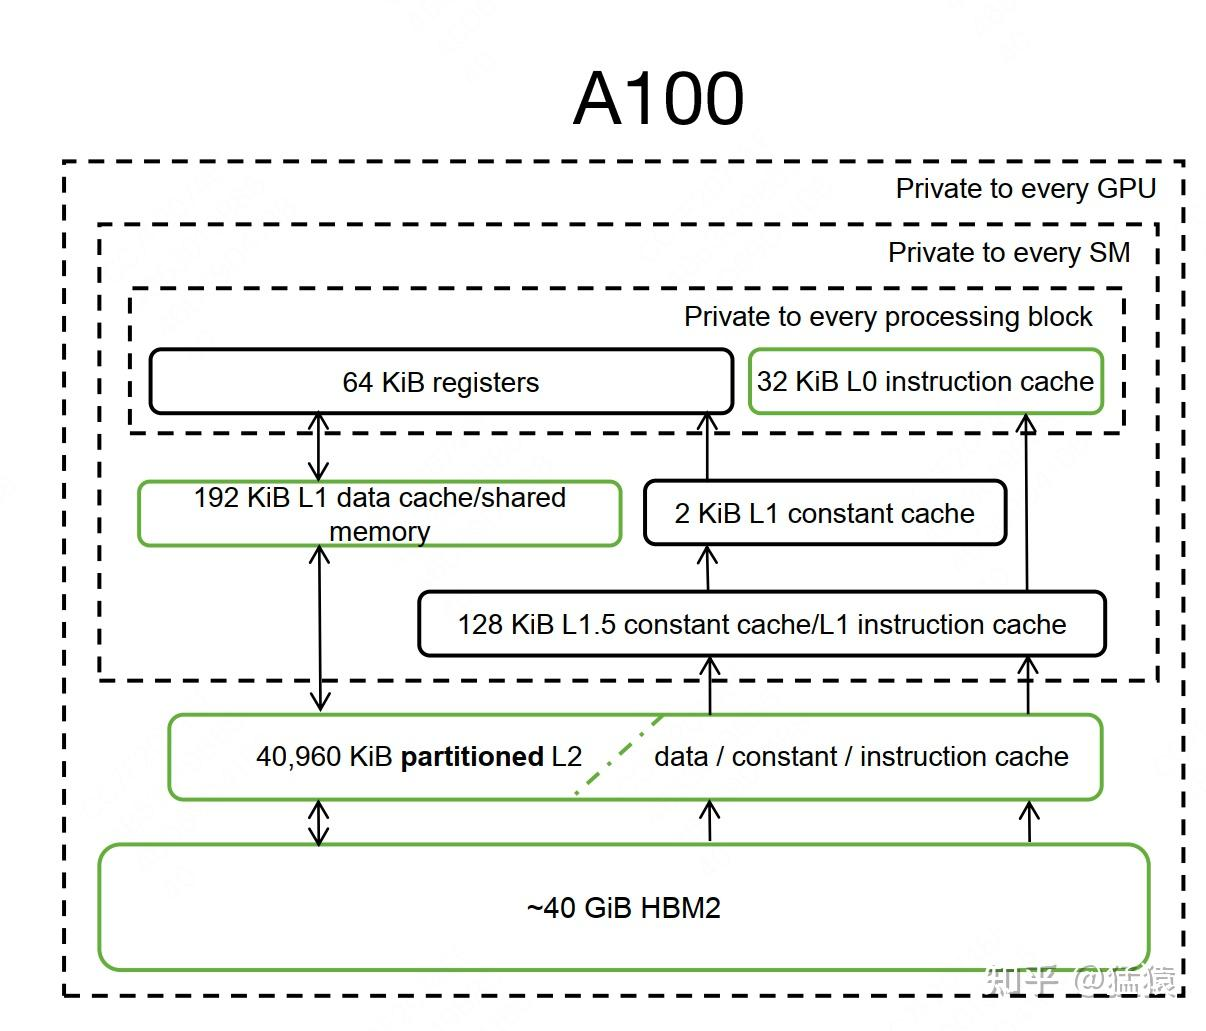
- HBM2:即是我们的显存。
- L1缓存/shared memory:每个SM都有自己的L1缓存,用于存储SM内的数据,被SM内所有的cuda cores共享。SM间不能互相访问彼此的L1。NV Volta架构后,L1和shared memory合并(Volta架构前只有Kepler做过合并),目的是为了进一步降低延迟。合并过后,用户能写代码直接控制的依然是shared memory,同时可控制从L1中分配多少存储给shared memory。Flash attention中SRAM指的就是L1 cache/shared memory。
- L2缓存:所有SM共享L2缓存。L2缓存不直接由用户代码控制。L1/L2缓存的带宽都要比显存的带宽要大,也就是读写速度更快,但是它们的存储量更小。
现在我们再理一遍GPU的计算流程:将数据从显存(HBM)加载至on-chip的SRAM中,然后由SM读取并进行计算。计算结果再通过SRAM返回给显存。
我们知道显存的带宽相比SRAM要小的多,读一次数据是很费时的,但是SRAM存储又太小,装不下太多数据。所以我们就以SRAM的存储为上限,尽量保证每次加载数据都把SRAM给打满,节省数据读取时间。
Kernel融合
前面说过,由于从显存读一次数据是耗时的,因此在SRAM存储容许的情况下,能合并的计算我们尽量合并在一起,避免重复从显存读取数据。
举例来说,我现在要做计算A和计算B。在老方法里,我做完A后得到一个中间结果,写回显存,然后再从显存中把这个结果加载到SRAM,做计算B。但是现在我发现SRAM完全有能力存下我的中间结果,那我就可以把A和B放在一起做了,这样就能节省很多读取时间,我们管这样的操作叫kernel融合。
由于篇幅限制,我们无法详细解释kernel这个概念,在这里大家可以粗犷地理解成是“函数”,它包含对线程结构(grid-block-thread)的定义,以及结构中具体计算逻辑的定义。理解到这一层已不妨碍我们对flash attention的解读了
kernel融合和尽可能利用起SRAM,以减少数据读取时间,都是flash attention的重要优化点。在后文对伪代码的解读中我们会看到,分块之后flash attention将矩阵乘法、mask、softmax、dropout操作合并成一个kernel,做到了只读一次和只写回一次,节省了数据读取时间。
Forward运作流程
标准attention计算
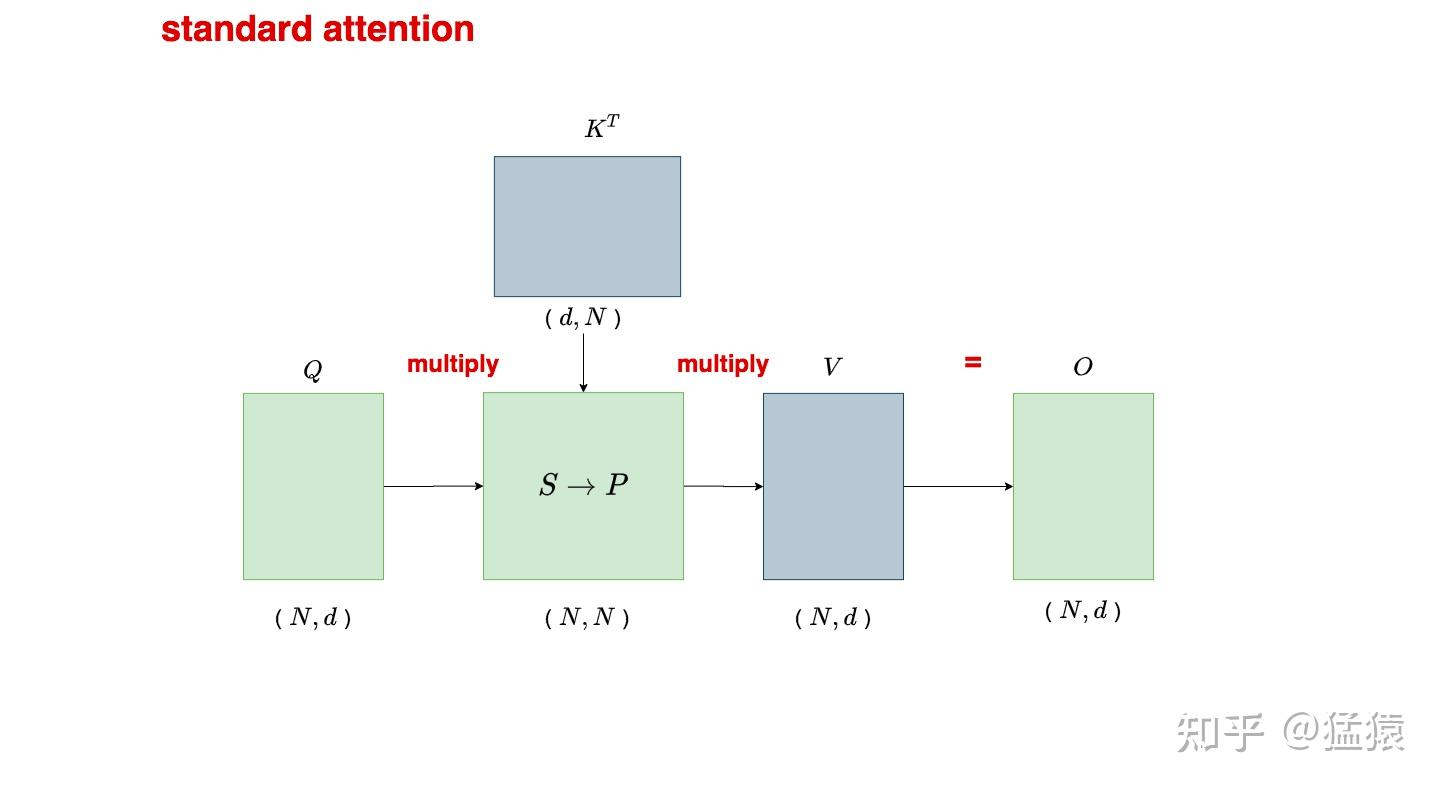
其中, $S=QK^T, P=softmax(S)$。在GPT类的模型中,还需要对 $P$做mask处理。为了表达方便,诸如mask、dropout之类的操作
标准Safe softmax
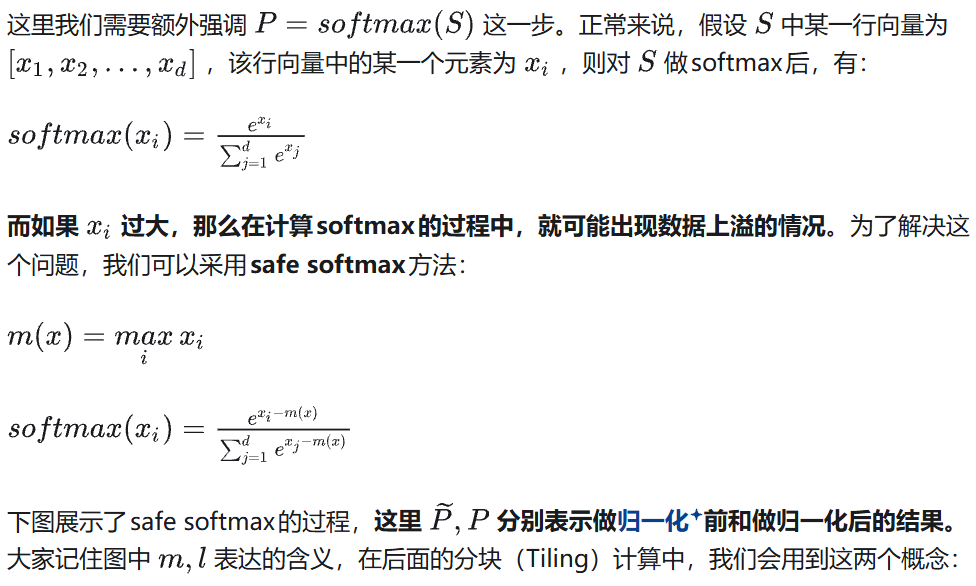
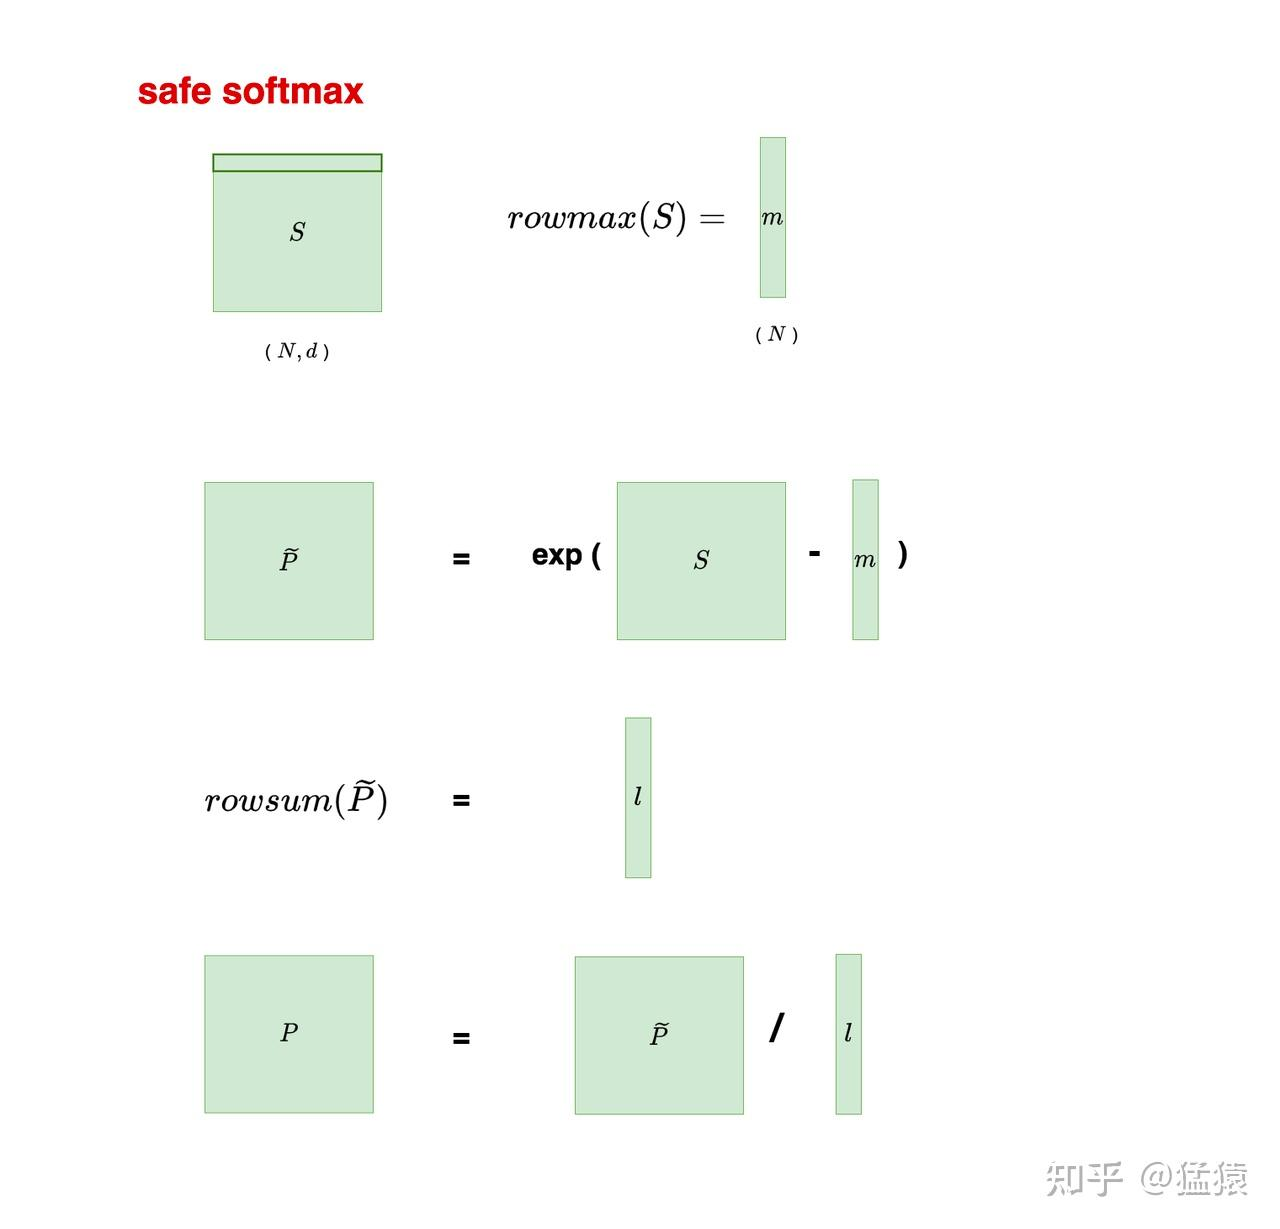
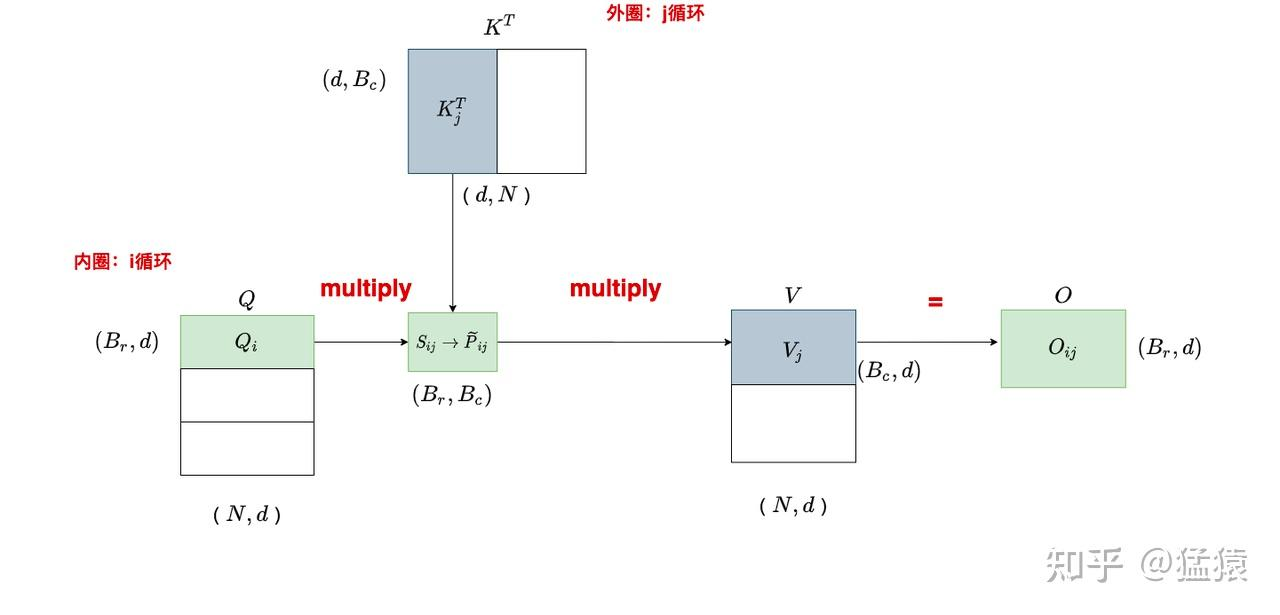
分块计算整体流程(Tiling)
-
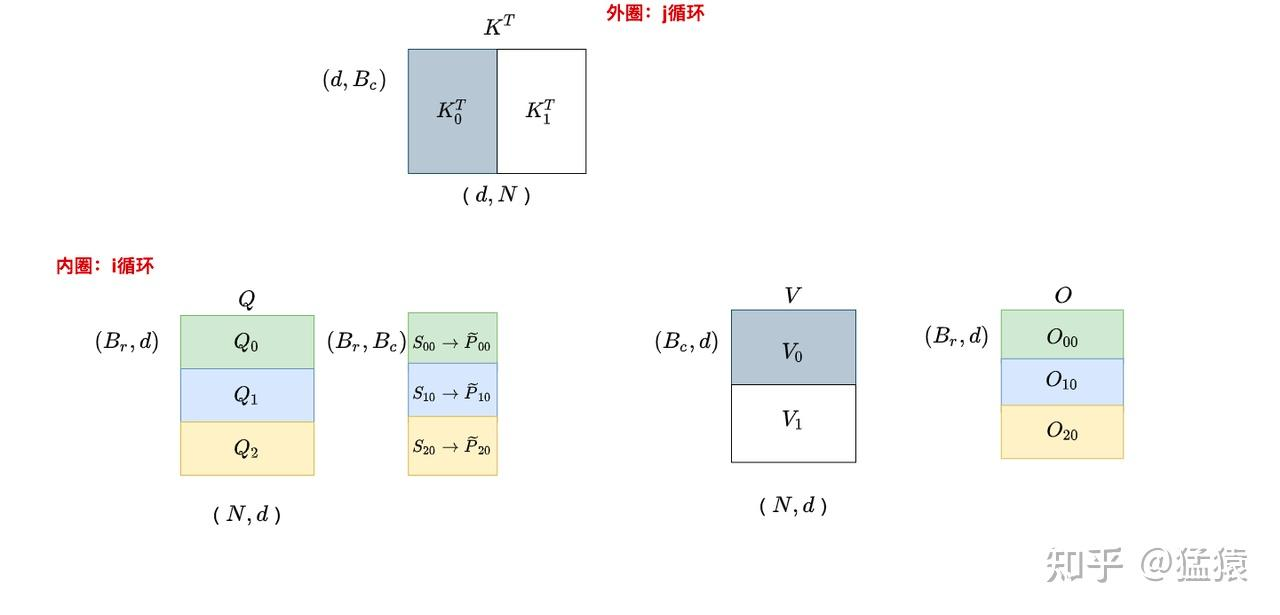
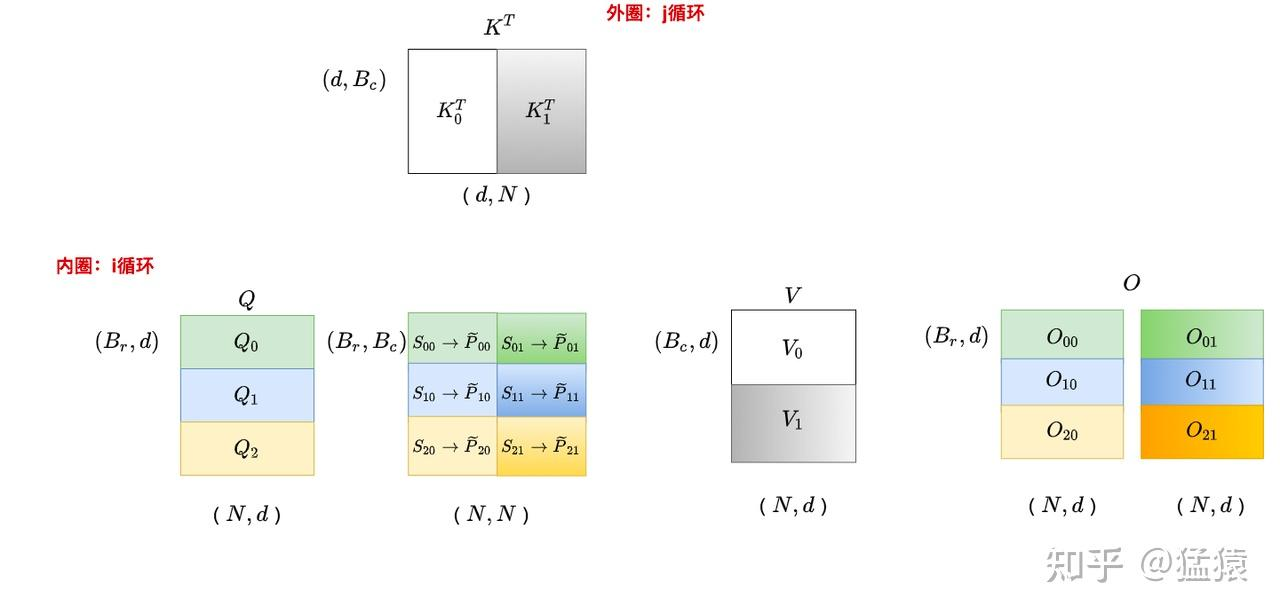
首先,将$Q$矩阵切为$T_r$块,每块的长度为$B_r$。用$Q_i$来表示切完后的某块矩阵,则$Q_i$的维度为$(B_r,d)$。$Q_i$中存储着$B_r$个token的query信息。
-
然后,将$K^T$矩阵切为$T_c$块,每块的长度为$B_c$。用$K_j^T$来表示切完后的某块矩阵,则$K_j^T$的维度为$(d,B_c)$。$K_j^T$中存储着$B_c$个token的key信息。
-
同样,将$V$矩阵切为$T_c$块,每块的长度为$B_c$。用$V_j$来表示切完后的某块矩阵,则$V_j$的维度为$(B_c,d)$。$V_j$中存储着$B_c$个token的value信息。
理解了上面的定义后,我们就可以开始做分块的attention计算了。以上图为例:
-
计算初始attention分数:$S_{ij} = Q_i * K_j^T = (B_r,d) * (d, B_c) = (B_r, B_c)$,图中的$S_{ij}$表示前$B_r$个token和前$B_c$个token间的原始相关性分数。
-
Safe softmax + mask + dropout:对 $S_{ij}$ 做safe softmax、mask和dropout操作,得到 $\hat{P_{ij}}$
-
计算output:$O_{ij} = \hat{P_{ij}} * V_j = (B_r, B_c) * (B_c, d) = (B_r, d)$
在计算这些分块时,GPU是可以做并行计算的,这也提升了计算效率
好!现在你已经知道了单块的计算方式,现在让我们把整个流程流转起来把。在上图中,我们注明了 $j$ 是外循环,$i$ 是内循环,这个意思就是说,对于每个 $j$ ,我们都把所有的 $i$遍历一遍,得到相关结果。在论文里,又称为K,V是外循环,Q是内循环:
# ---------------------
# Tc: K和V的分块数
# Tr: Q的分块数量
# ---------------------
for 1 <= j <= Tc:
    for 1 <= i <= Tr:
        do....
残留的问题:
- 分块后,要如何正确计算attention score?(即$S,P$的计算方法)
- 分块后,要如何正确计算输出$O$?
- 分块后,是如何实现优化I/O,解决memory-bound的问题的?