Roofline
先说一下上次遗留下来的一些问题:Roofline
上次只是粗浅的知道了Roofline大概的落点在哪,但是对于它实际的意义其实我并没我想象中的清楚,所以这次仔细研究一下:
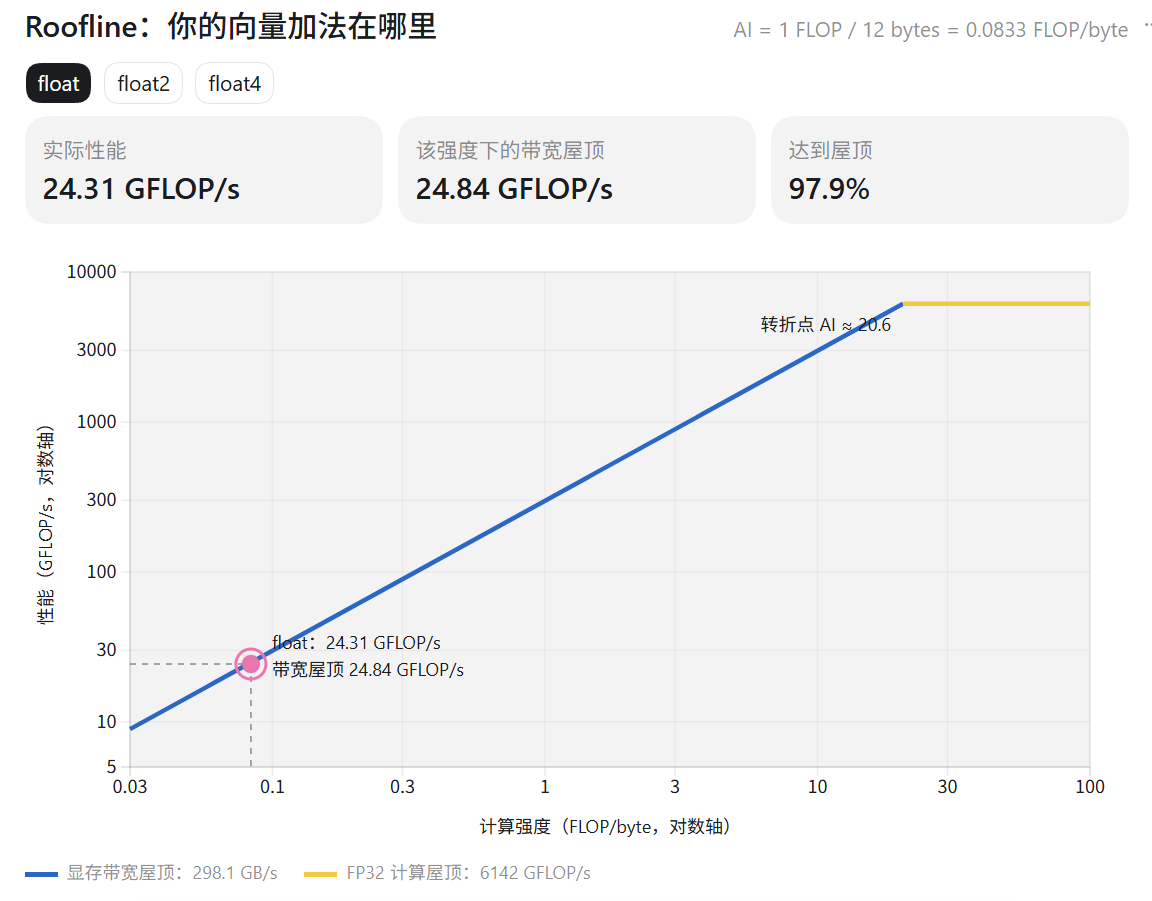
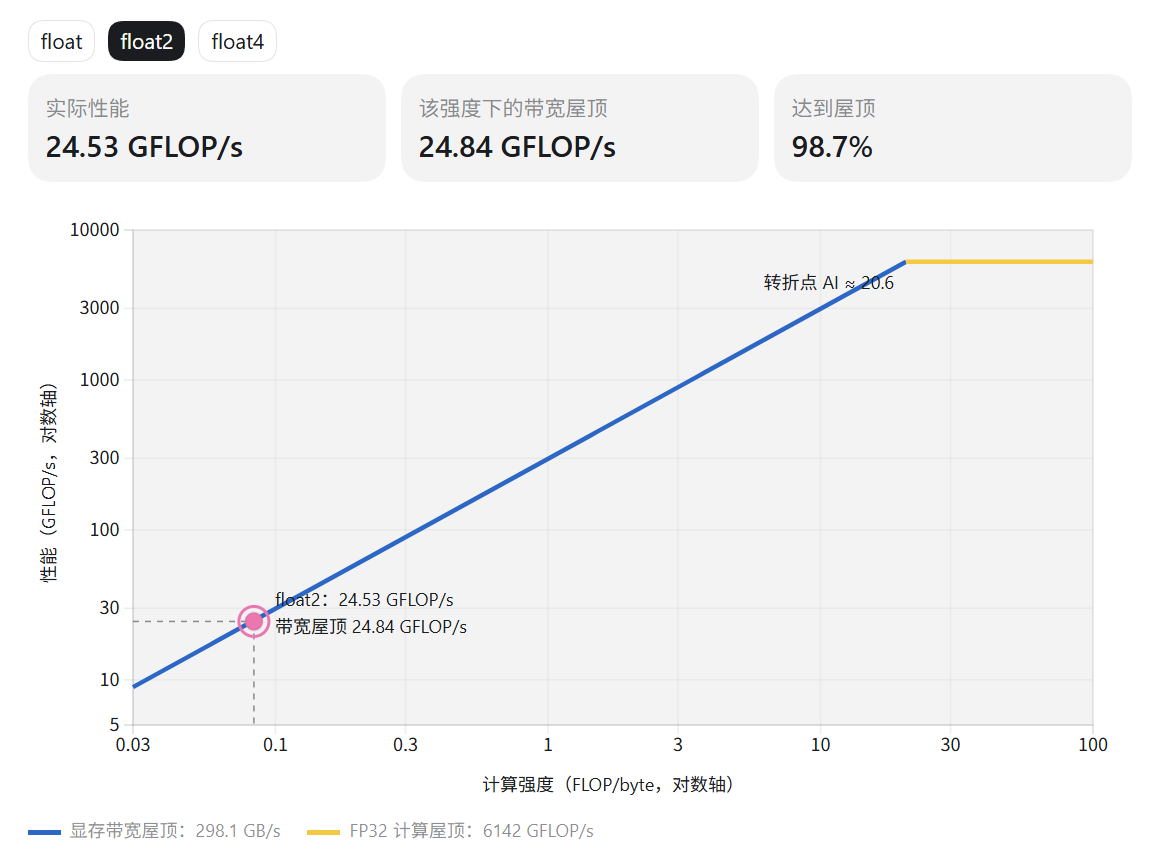
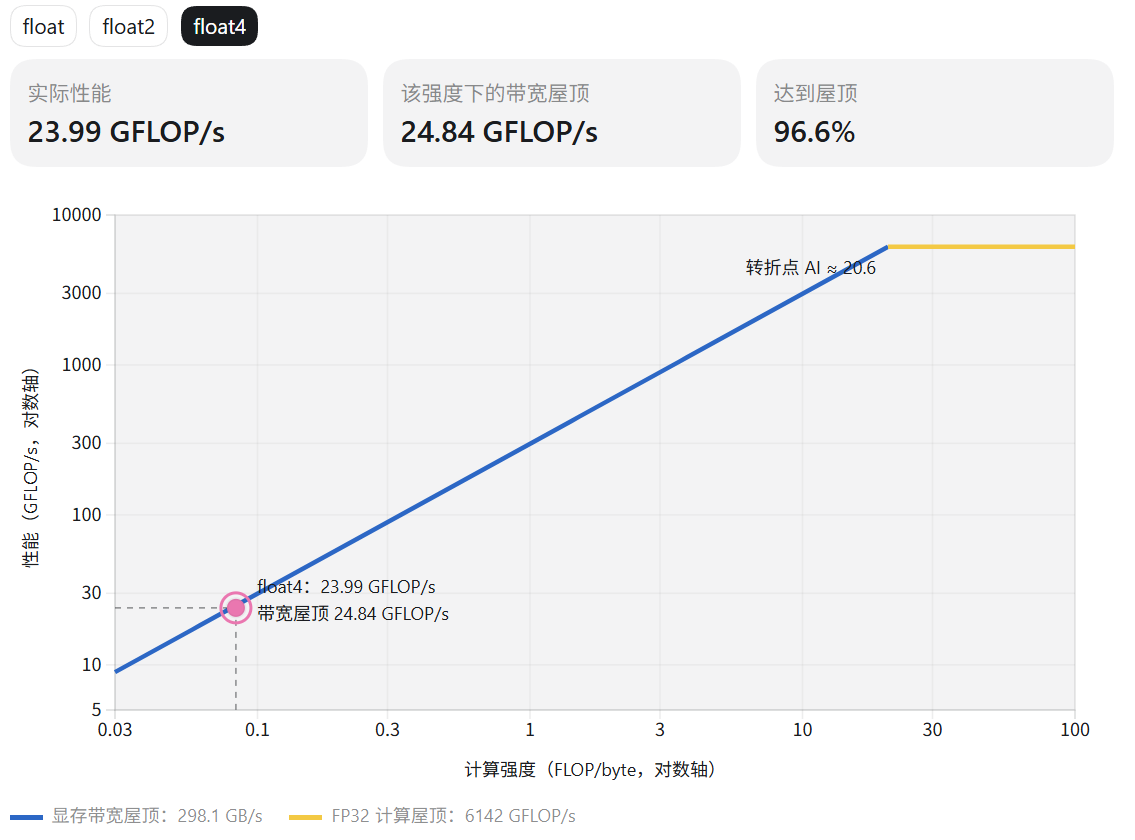
Roofline回答的是:对于一个 kernel,根据“每搬运一个字节做多少计算”,这块 GPU 理论上最多能达到多少计算性能?
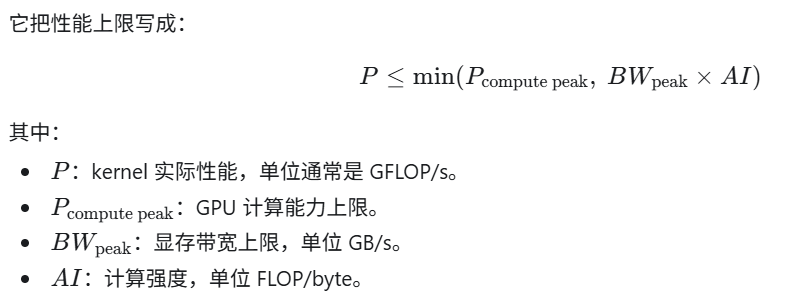
一个kernel同时受到两个上限约束:计算能力上限和显存搬运能力上限
横坐标是计算强度:$AI=\frac{完成的有效浮点运算次数}{搬运的字节数}$
例如我们的vector_add:搬运12bytes,只做一次加法,那么我们的计算强度是:
$AI = \frac{W}{Q} = \frac{1}{12} = 0.0833FLOP/byte$
倾斜线是显存带宽屋顶:$P_{memory roof} = BW_{peak} \times AI$
NCU报告中给出的Roofline参数大约是 $BW_{peak} = 298.1 GB/s$,所以在这个计算强度下,GPU最多达到$P_{memory roof} = 298.1 \times 0.0833 = 24.84 GFLOP/s$。
水平线是计算屋顶:$P_{compute roof} = 6142 GFLOP/s$,它表示在当前NCU记录的频率状态下,GPU的FP32理论的计算上限
计算累加
有竞争的情况下
template <typename T>
__global__ void sum_kernel(T *result, const T *num, size_t n){
    size_t idx = (blockDim.x * blockIdx.x) + threadIdx.x;
    if (idx < n) {
        *result += num[idx];
    }
}

int main(){
    size_t SIZE = 1 << 20 ;
    std::vector<float> h_vec(SIZE,0);

    float h_ans = static_cast<float>(0);
    std::vector<float> d_ans(1);

    for (size_t i = 0; i < SIZE; i ++){
        h_vec[i] = static_cast<float>(i % 97) - 48.0f;
        h_ans += h_vec[i];
    }
    float *ans = nullptr;
    float *vec = nullptr;

    CUDA_CHECK(cudaMalloc(&vec, static_cast<size_t>(SIZE * sizeof(float))));
    CUDA_CHECK(cudaMalloc(&ans, static_cast<size_t>(sizeof(float))));

    CUDA_CHECK(cudaMemcpy(vec, h_vec.data(), static_cast<size_t>(SIZE * sizeof(float)), cudaMemcpyHostToDevice));
    CUDA_CHECK(cudaMemset(ans, 0, sizeof(float)))
    unsigned int block_size = 256 ;
    dim3 block_dim(block_size);
    unsigned int grid_size = static_cast<unsigned int>((SIZE / block_size) + (SIZE % block_size != 0));
    dim3 grid_dim(grid_size);
    sum_kernel<float><<<grid_dim, block_dim>>>(ans, vec, SIZE);
    CUDA_CHECK(cudaGetLastError());
    CUDA_CHECK(cudaDeviceSynchronize());

    CUDA_CHECK(cudaMemcpy(d_ans.data(), ans, static_cast<size_t>(sizeof(float)), cudaMemcpyDeviceToHost));
    if (fabs(d_ans[0] - h_ans) > 1e-5){
        std::cerr << "d_ans: " << d_ans[0] << "\n" << "h_ans: " << h_ans << "\nfailed!\n\n";
        return 0;
    }
    std::cout << "passed!\n\n";
    return 0;
}
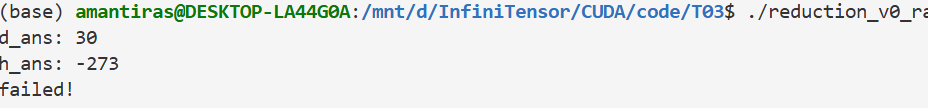
结果不出意外的出意外了:
Atomic操作
template <typename T>
__global__ void sum_kernel(T *result, const T *num, size_t n){
    size_t idx = (blockDim.x * blockIdx.x) + threadIdx.x;
    if (idx < n) {
        atomicAdd(result, num[idx]);
    }
}

我自己懒得跑了,看ppt的说法是原子操作后计算与内存吞吐/利用率都很低,很多线程都在闲置,这是由于原子操作导致线程之间完全串行!
这里很容易想到:分治算法,不需要每个线程都直接加到最终的result里面,放到这里的说法是分治规约。
warp内的分治规约
template <typename T>
__global__ void reduce_warp_global_kernel(T *output, const T *input, size_t n){
    size_t tid = threadIdx.x;
    unsigned int lane_id = tid % 32;
    size_t idx = blockIdx.x * blockDim.x + tid;
    if (lane_id == 0) {
        T warp_sum = 0;
        const size_t step = blockDim.x * gridDim.x;
        const size_t total_elements = ((n - idx) + step - 1) / step;

        for (size_t linear_idx = 0; linear_idx < total_elements * 32; ++ linear_idx) {
            const size_t segment = linear_idx / 32 ;
            const size_t lane = linear_idx % 32;
            const size_t j = idx + segment * step + lane;

            if (j < n) {
                warp_sum += input[j];
            }
        }

        atomicAdd(output, warp_sum);
    }
}
这里设计的这么复杂是为了让访问顺序变成线性,如果我们这样做:
for (i = 0; i < 32; ++i) {
    for (j = idx + i; j < n; j += step) {
        warp_sum += input[j];
    }
}
那么访问顺序:
i=0:  0, 128, 256
i=1:  1, 129, 257
i=2:  2, 130, 258
...
i=31: 31, 159, 287
这里将两层循环展平成了一层,访问顺序变为:
0, 1, 2, ..., 31,
128, 129, 130, ..., 159,
256, 257, 258, ..., 287
block内的分治规约
template <typename T>
__global__ void reduce_block_global_kernel(T *output, const T *input, size_t n){
    size_t tid = threadIdx.x;
    size_t idx = blockIdx.x * blockDim.x + tid;

    if (tid == 0) {
        T block_sum = 0;
        for (size_t i = 0; i < blockDim.x; i ++){
            for (size_t j = idx + i; j < n; j += blockDim.x * gridDim.x){
                block_sum += input[j];
            }
        }
        atomicAdd(output, block_sum);
    }
}
Intra-block 的比 intra-warp 的版本计算利用率和活跃warp 数都要低不少
虽然减少了原子累加的操作数,但单个线程的计算量增加太大,利用率/效率变低
GPU理论知识
共享内存树状规约
template <typename T>
__global__ void reduce_smem_tree_kernel(T *output, const T *input, size_t n){
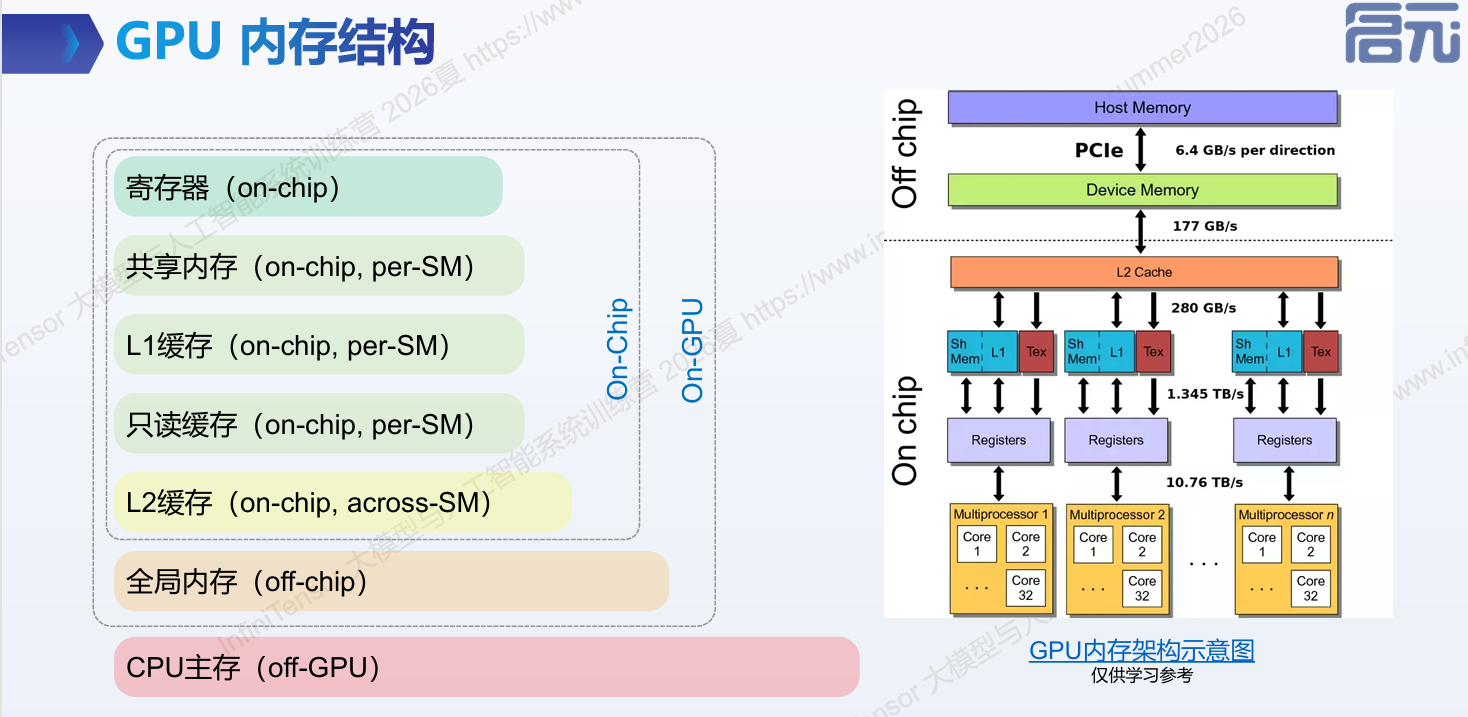
    extern __shared__ T smem[];
    size_t tid = threadIdx.x;
    size_t idx = blockIdx.x * blockDim.x + tid;

    smem[tid] = (idx < n) ? input[idx] : 0;
    __syncthreads();

    for (int s = blockDim.x / 2; s > 0; s >>= 1) {
        if (tid < s){
            smem[tid] += smem[tid + s];
        }
        __syncthreads();
    }

    if (tid == 0) {
        atomicAdd(output, smem[0]);
    }
}
每个 block 先在共享内存中求出自己的局部和,最后由每个 block 的线程0通过一次 atomicAdd 写入全局结果。
这里调用时:
int block_size = 256;
int grid_size = (n + block_size - 1) / block_size;

reduce_smem_tree_kernel<float>
    <<<grid_size, block_size, block_size * sizeof(float)>>>(
        output,
        input,
        n
    );
第三个启动参数就是为每个block分配的动态共享内存大小
现在我把目前得到的结果的性能给汇总一下

v2_block相比v1_atomic快约5.36x。v2_warp相比v2_block快约3.41x。v3_smem相比v2_warp快约2.43x。v3_smem相比v1_atomic快约44.35x。


所有版本的计算强度都远低于约 20.59 FLOP/byte 的 Ridge Point,因此在经典双屋顶图中位于带宽斜线一侧。但这只说明 DRAM 屋顶低于 FP32 计算屋顶,不表示实际执行一定已经被 DRAM 带宽卡住。
v1_atomic远低于自己的内存屋顶,并且 DRAM 利用率只有1.73%。主要瓶颈是大量线程竞争同一个全局原子地址。v2_block的有效 AI 已恢复到约0.25,但 Achieved Occupancy 只有16.34%。每个 block 只有线程 0 工作,绝大多数线程资源没有产生有效计算。v2_warp增加了工作线程数量,性能明显提升;但每个 warp 仍只有 lane 0 工作,NCU 观察到约10.09 MB的 DRAM 流量,高于输入的4.00 MiB。v3_smem使用合并的全局内存读取,并将全局原子操作降到每个 block 一次,因此是当前最快的正确版本。v3_smem的 DRAM 利用率只有16.40%,而 LSU/shared-memory 相关吞吐达到约84%。当前继续优化时应重点减少共享内存指令和__syncthreads(),例如在最后一个 warp 中使用__shfl_down_sync。
warp规约优化
__shfl_down_sync
__shfl_down_sync是允许线程直接从同一个warp中另一个线程的寄存器中读取数据。数据传输直接在寄存器之间完成,完全不需要占用Shared Memory资源。这释放了Shared Memory供其他计算或更大的Block使用。
寄存器(Registers)是 GPU 上访问速度最快的存储介质。寄存器之间的直接数据交换(通过硬件层面的 Shuffle 单元)比经过 Shared Memory 读写的时延低得多,执行速度更快。
这里会注意到它不需要同步,因为上一例中我们使用了__syncthreads去做块内同步,而在Warp 内部,32 个线程本来就是以 SIMT(单指令多线程)方式隐式同步执行的。
使用 __shfl_down_sync 时,掩码(如代码中的 0xFFFFFFFF,代表 Warp 内所有 32 个线程全部参与)能够安全地在指令级别协调数据传输,省去了编写 __syncthreads() 的麻烦,同时也避免了因错误同步导致的性能下降或死锁风险。
具体实现
template <typename T>
__global__ void reduce_warp_shfl_register_kernel(T *output, const T *input, size_t n){
    size_t tid = threadIdx.x;
    size_t idx = blockIdx.x * blockDim.x + tid;

    T sum = 0;
    for (size_t i = idx; i < n; i += blockDim.x * gridDim.x) {
        sum += input[i] ;
    }

    for (int offset = 16; offset > 0; offset >>= 1) {
        sum += __shfl_down_sync(0xFFFFFFF, sum, offset);
    }

    if (tid % 32 == 0) {问你个问题,《情爱现象学》中爱会有个什么高潮之后的断崖,然后作者提到了什么光环,圣像的破灭,然后我如果要继续爱会有个什么末世论的爱,那这里的爱和圣像或者光环那个阶段的爱有什么区别呢
        atomicAdd(output, sum);
    }
}
这里利用了 CUDA 的 Warp Shuffle(束内洗牌) 机制,在同一个 Warp(包含 32 个线程)内部进行树状相加。
offset 从 16 开始,每次减半(16 -> 8 -> 4 -> 2 -> 1)。
循环结束后,每个 Warp 内的第 0 号线程(Lane 0)的 sum 寄存器中,就保存了该 Warp 所负责处理的所有数据的总和。
这里确实有明显的提升,但是跟目前最快的smem-tree比起来差距还是很大,这是因为我们没对warp间规约优化,于是我们想到,将原来的smem手动树状规约换成warp-shuffle规约:
更牛的规约
template <typename T>
__device__ T warp_reduce(T val){
#pragma unroll
    for (int offset = 16; offset > 0; offset >>= 1) {
        val += __shfl_down_sync(0xFFFFFFF, val, offset);
    }
    return val;
}

template <typename T>
__global__ void reduce_warp_shuffle_kernel(T *output, const T *input, size_t n){
    extern __shared__ T smem[];
    size_t tid = threadIdx.x;
    size_t idx = blockIdx.x * blockDim.x + tid;

    T sum = 0;
    for (size_t i = idx; i < n; i += blockDim.x * gridDim.x) {
        sum += input[i];
    }
    T warp_sum = warp_reduce(sum);
    if (tid % 32 == 0) {
        smem[tid / 32] = warp_sum;
    }
    __syncthreads();

    if (tid < 32) {
        T block_sum = (tid < (blockDim.x + 31) / 32) ? smem[tid] : T(0);
        block_sum = warp_reduce(block_sum);
        if (tid == 0) {
            atomicAdd(output, block_sum);
        }
    }
}
这个不仅在warp内做规约,也在block内做规约,但是我们注意到在block间,它还是使用了原子操作,这里我们还可以对它进行优化。
cooperative优化
最后看一段代码,我们就基本结束在规约优化上的学习。这里我写的细致一点,因为一方面确实比较难细节比较多,另一方面我自己也好梳理相关内容。
#include <iostream>
#include <iomanip>
#include <vector>
#include <cmath>
#include <algorithm>
#include <cstdlib>
#include <cuda_runtime.h>
#include <cstdint>
#include <type_traits>问你个问题,《情爱现象学》中爱会有个什么高潮之后的断崖,然后作者提到了什么光环,圣像的破灭,然后我如果要继续爱会有个什么末世论的爱,那这里的爱和圣像或者光环那个阶段的爱有什么区别呢
#include <cooperative_groups.h>
namespace cg = cooperative_groups;


#define CUDA_CHECK(call) { \
    cudaError_t err = call ;   \
    if (err != cudaSuccess){ \
        std::cerr << "CUDA error at " << __FILE__ << ":" << __LINE__ << ": " \
                  << cudaGetErrorString(err) << '\n'; \
        exit(1); \
    }    \
} \

template <typename T>
__device__ T warp_reduce(T val){
#pragma unroll
    for (int offset = 16; offset > 0; offset >>= 1) {
        val += __shfl_down_sync(0xFFFFFFFF, val, offset);
    }
    return val;
}

template <typename T>
__global__ void reduce_cooperative_kernel(T *output, const T *input, size_t n) {
    extern __shared__ __align__(sizeof(T)) unsigned char shared_mem_raw[];
    T* coop_smem = reinterpret_cast<T*>(shared_mem_raw);

    auto grid = cg::this_grid();
    auto block = cg::this_thread_block();
    size_t tid = threadIdx.x;
    size_t idx = blockIdx.x * blockDim.x + tid;

    T sum = 0;
    for (size_t i = idx; i < n; i += gridDim.x * blockDim.x) {
        sum += input[i];
    }

    T warp_sum = warp_reduce(sum);

    if (tid % 32 == 0) {
        coop_smem[tid / 32] = warp_sum;
    }
    block.sync();

    if (tid < 32) {
        T block_sum = (tid < (blockDim.x + 31) / 32) ? coop_smem[tid] : T(0);
        block_sum = warp_reduce(block_sum);
        if (tid == 0){
            output[blockIdx.x] = block_sum;
        }
    }
    grid.sync();

    if (blockIdx.x == 0){
        T final_sum = 0;
        for (size_t i = tid; i < gridDim.x; i += blockDim.x){
            final_sum += output[i];
        }

        T warp_val = warp_reduce(final_sum);

        if (tid % 32 == 0) {
            coop_smem[tid / 32] = warp_val;
        }
        block.sync();

        if (tid < 32) {
            T v = (tid < (blockDim.x + 31) / 32) ? coop_smem[tid] : T(0);
            T total = warp_reduce(v);
            if (tid == 0){
                output[0] = total;
            }
        }
    }
}

int main(){
    size_t SIZE = 1 << 20 ;
    std::vector<float> h_vec(SIZE,0);

    float h_ans = static_cast<float>(0);
    std::vector<float> d_ans(1);

    for (size_t i = 0; i < SIZE; i ++){
        h_vec[i] = static_cast<float>(i % 97) - 48.0f;
        h_ans += h_vec[i];
    }
    float *ans = nullptr;
    float *vec = nullptr;

    CUDA_CHECK(cudaMalloc(&vec, static_cast<size_t>(SIZE * sizeof(float))));


    CUDA_CHECK(cudaMemcpy(vec, h_vec.data(), static_cast<size_t>(SIZE * sizeof(float)), cudaMemcpyHostToDevice));


    cudaDeviceProp props;
    CUDA_CHECK(cudaGetDeviceProperties(&props, 0));

    const size_t block_size = 256;
    int grid_size = 0;
    size_t smem_size = ((block_size + 31) / 32) * sizeof(float);
    CUDA_CHECK(cudaOccupancyMaxActiveBlocksPerMultiprocessor(
        &grid_size,
        reduce_cooperative_kernel<float>,
        block_size,
        smem_size
    ));

    grid_size *= props.multiProcessorCount;

    CUDA_CHECK(cudaMalloc(&ans, static_cast<size_t>(grid_size * sizeof(float))));
    CUDA_CHECK(cudaMemset(ans, 0, grid_size * sizeof(float)))

    dim3 block_dim(block_size);
    dim3 grid_dim(grid_size);

    int can_launch = 0;
    CUDA_CHECK(cudaDeviceGetAttribute(&can_launch, cudaDevAttrCooperativeLaunch, 0));
    if (!can_launch){
        std::cerr << "Error: Device does not support cooperative launches! \n";
        exit(1);
    }

    void* kernelArgs[] = {&ans, &vec, &SIZE};
    CUDA_CHECK(cudaLaunchCooperativeKernel(
        (void *)reduce_cooperative_kernel<float>,
        grid_dim,
        block_dim,
        kernelArgs,
        smem_size,
        0
    ));


    CUDA_CHECK(cudaGetLastError());
    CUDA_CHECK(cudaDeviceSynchronize());

    CUDA_CHECK(cudaMemcpy(d_ans.data(), ans, static_cast<size_t>(sizeof(float)), cudaMemcpyDeviceToHost));
    if (fabs(d_ans[0] - h_ans) > 1e-5){
        std::cerr << "d_ans: " << d_ans[0] << "\n" << "h_ans: " << h_ans << "\nfailed!\n\n";
        return 0;
    }
    std::cout << "passed!\n\n";
    return 0;
}
前置知识
我发现其实我对于grid, block, warp, lane还是没有那么清楚,所以这里我详细阐述一下:
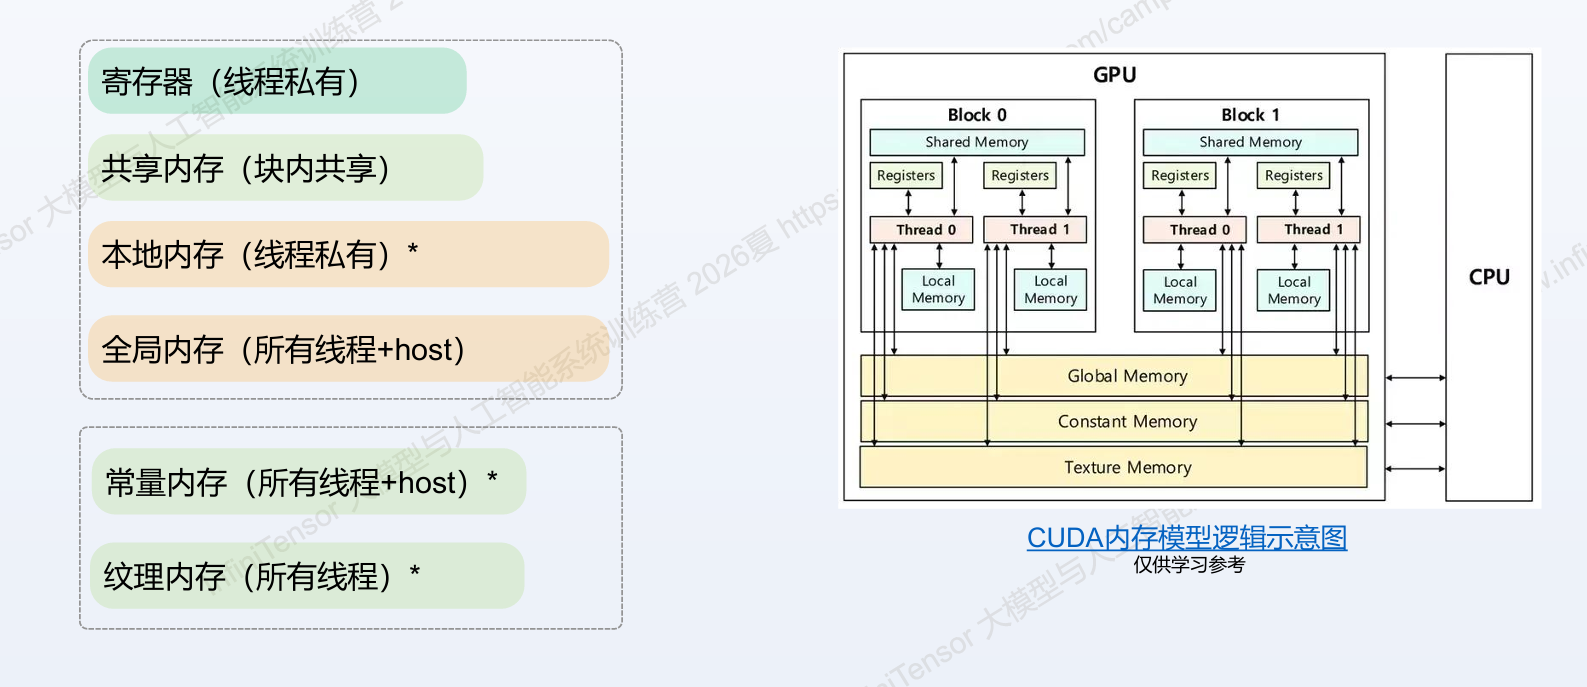
grid是网络,是最高层级,代表整个内核函数启动的所有线程的集合,它的大小由gridDim.x决定,这里gridDim.x其实就是一共启动的block数量。
Block是线程块,一个grid由多个block组成,同一个Block 内的线程可以通过共享内存(Shared Memory)通信,这也是为什么我们代码中在做warp_reduce时,一定是同一个block内部做,而且我们可以用block.sync()同步。大小由blockDim.x决定,也就是每个block内有block.Dim.x个线程。
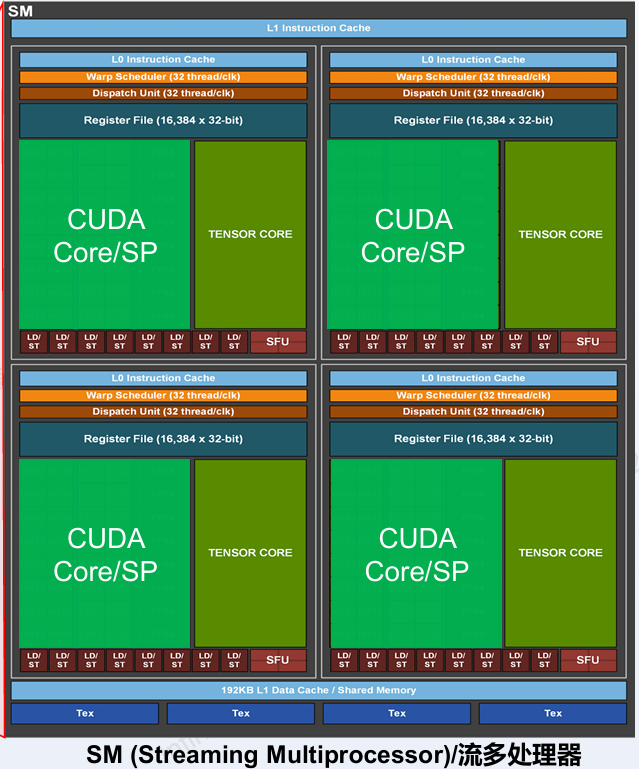
warp是线程束,硬件调度基本单位。GPU 硬件层面强制规定:无论你怎么写,32 个线程组成一个 Warp(SIMT 架构)。如果blockDim.x = 256,那么每个 Block 内部刚好包含 256 / 32 = 8 个 Warp。
Lane,最微观层级。指一个 Warp 内部的具体某一个线程(编号从 0 到 31)。比如代码里的 tid % 32 == 0,就是指每个 Warp 里的 Lane 0(第 0 号线程)。
相关代码书写的知识
block.sync(): __syncthreads()
grid.sync(): 跨block同步
cudaOccupancyMaxActiveBlocksPerMultiprocessor():获取每SM对给定kernel和配置下的最大的线程块数量。
cudaDevAttrCooperativeLaunch/ prop.cooperativeLaunch: 确保运行环境支持Cooperative Group
cudaLaunchCooperativeKernel(): 发射使用Cooperative Group的核函数
代码逻辑
首先是Grid-stride Loop:以总线程数为步长,跳跃式地读取input中的元素并累加到私有寄存器变量中,所以这里我们每个线程都有相关累加的值了。
然后进行warp内规约,得到每个warp的局部和,然后把warp的局部和写入coop_smem中,这里注意这个coop_smem是每个block都有一个的,随后执行block内同步,等待该block内所有warp写入完毕。
然后我们进行block级别的规约:仅让前 32 个线程(Lane 0 ~ 31)从共享内存中读取数据,再做一次 warp_reduce,得到整个 Block 的最终和(block_sum)。这里注意到tid<32,很自然会想到这万一这个每个block的warp数量大于32怎么办,实际不用担心,因为warp数量规定最多32.
tid == 0 的线程将该 Block 的计算结果写入全局内存的 output[blockIdx.x] 中。此时,output 数组的前 gridDim.x 个元素分别存着各个 Block 的局部和。
然后grid.sync()进行全网格同步,它强制等待整个 GPU 上启动的所有 Block 全部执行完第一阶段,并确保所有 Block 的局部和都已经安全写入了全局内存 output 中。如果没有这个全局同步,后续的跨 Block 归约就会读到脏数据。
最后块0内部采用网格跨步循环的方式读入数据,最后warp规约等等,和前面操作就很类似了。
Bank Conflict


