上一节讲的是V1,这一节讲的是V2.同样参考文章:https://zhuanlan.zhihu.com/p/691067658
V2的原理其实非常简单:无非是将V1计算逻辑中的内外循环相互交换,以此减少在shared memory上的读写次数,实现进一步提速。那当你交换了循环位置之后,在cuda层面就可以配套做一些并行计算优化。这就是V2的整体内容。
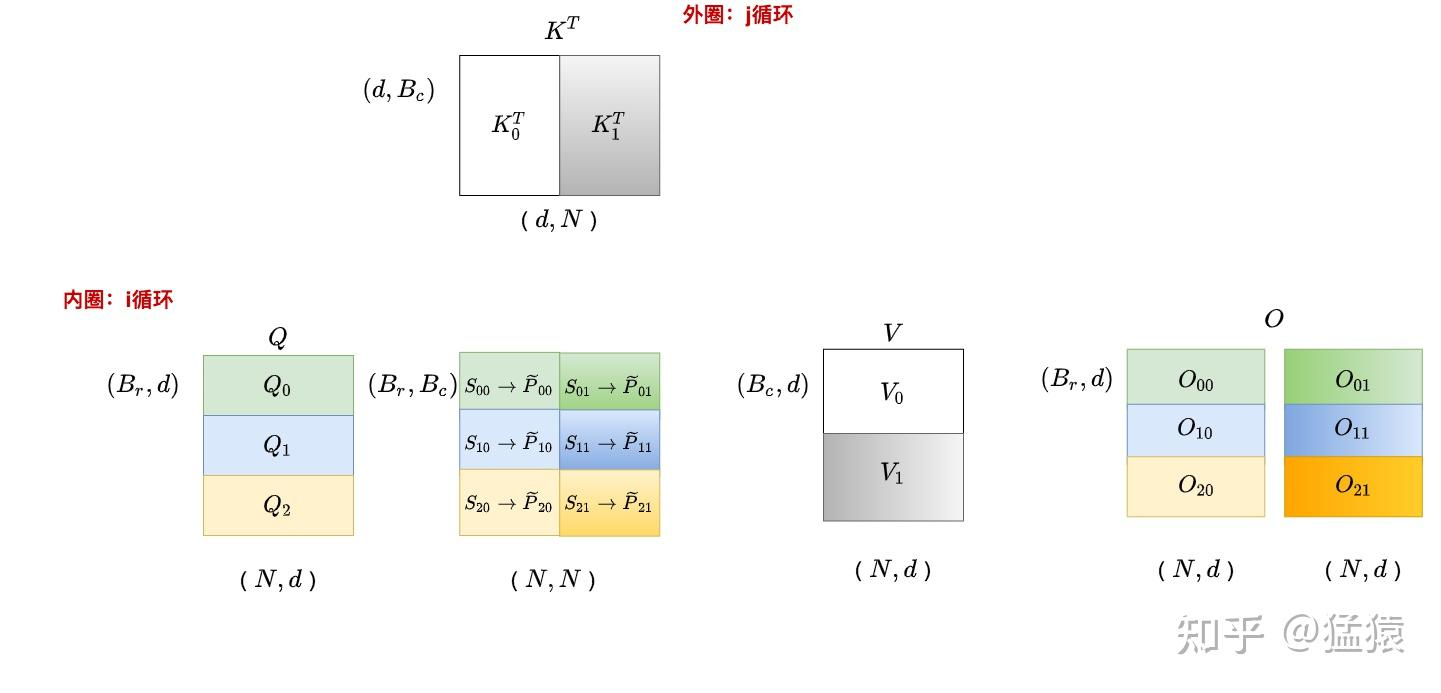
我们观察上图的过程,我们是先得到了$O_{00},O_{10},O_{20}$,再得到$O_{01},O_{11},O_{21}$.
那么如果熟悉CUDA操作,我们发现,上述的操作,我们可以把第一个外循环的内如读入shared memory然后再产出最终的结果。
那么为什么我们不把Q作为外循环,KV作为内循环呢?这样能够避免往shared memory上读写中间结果。
softmax这个操作也是在row维度上的,所以我固定Q循环KV的方式,更天然符合softmax的特性。
V2 的运作流程
forward
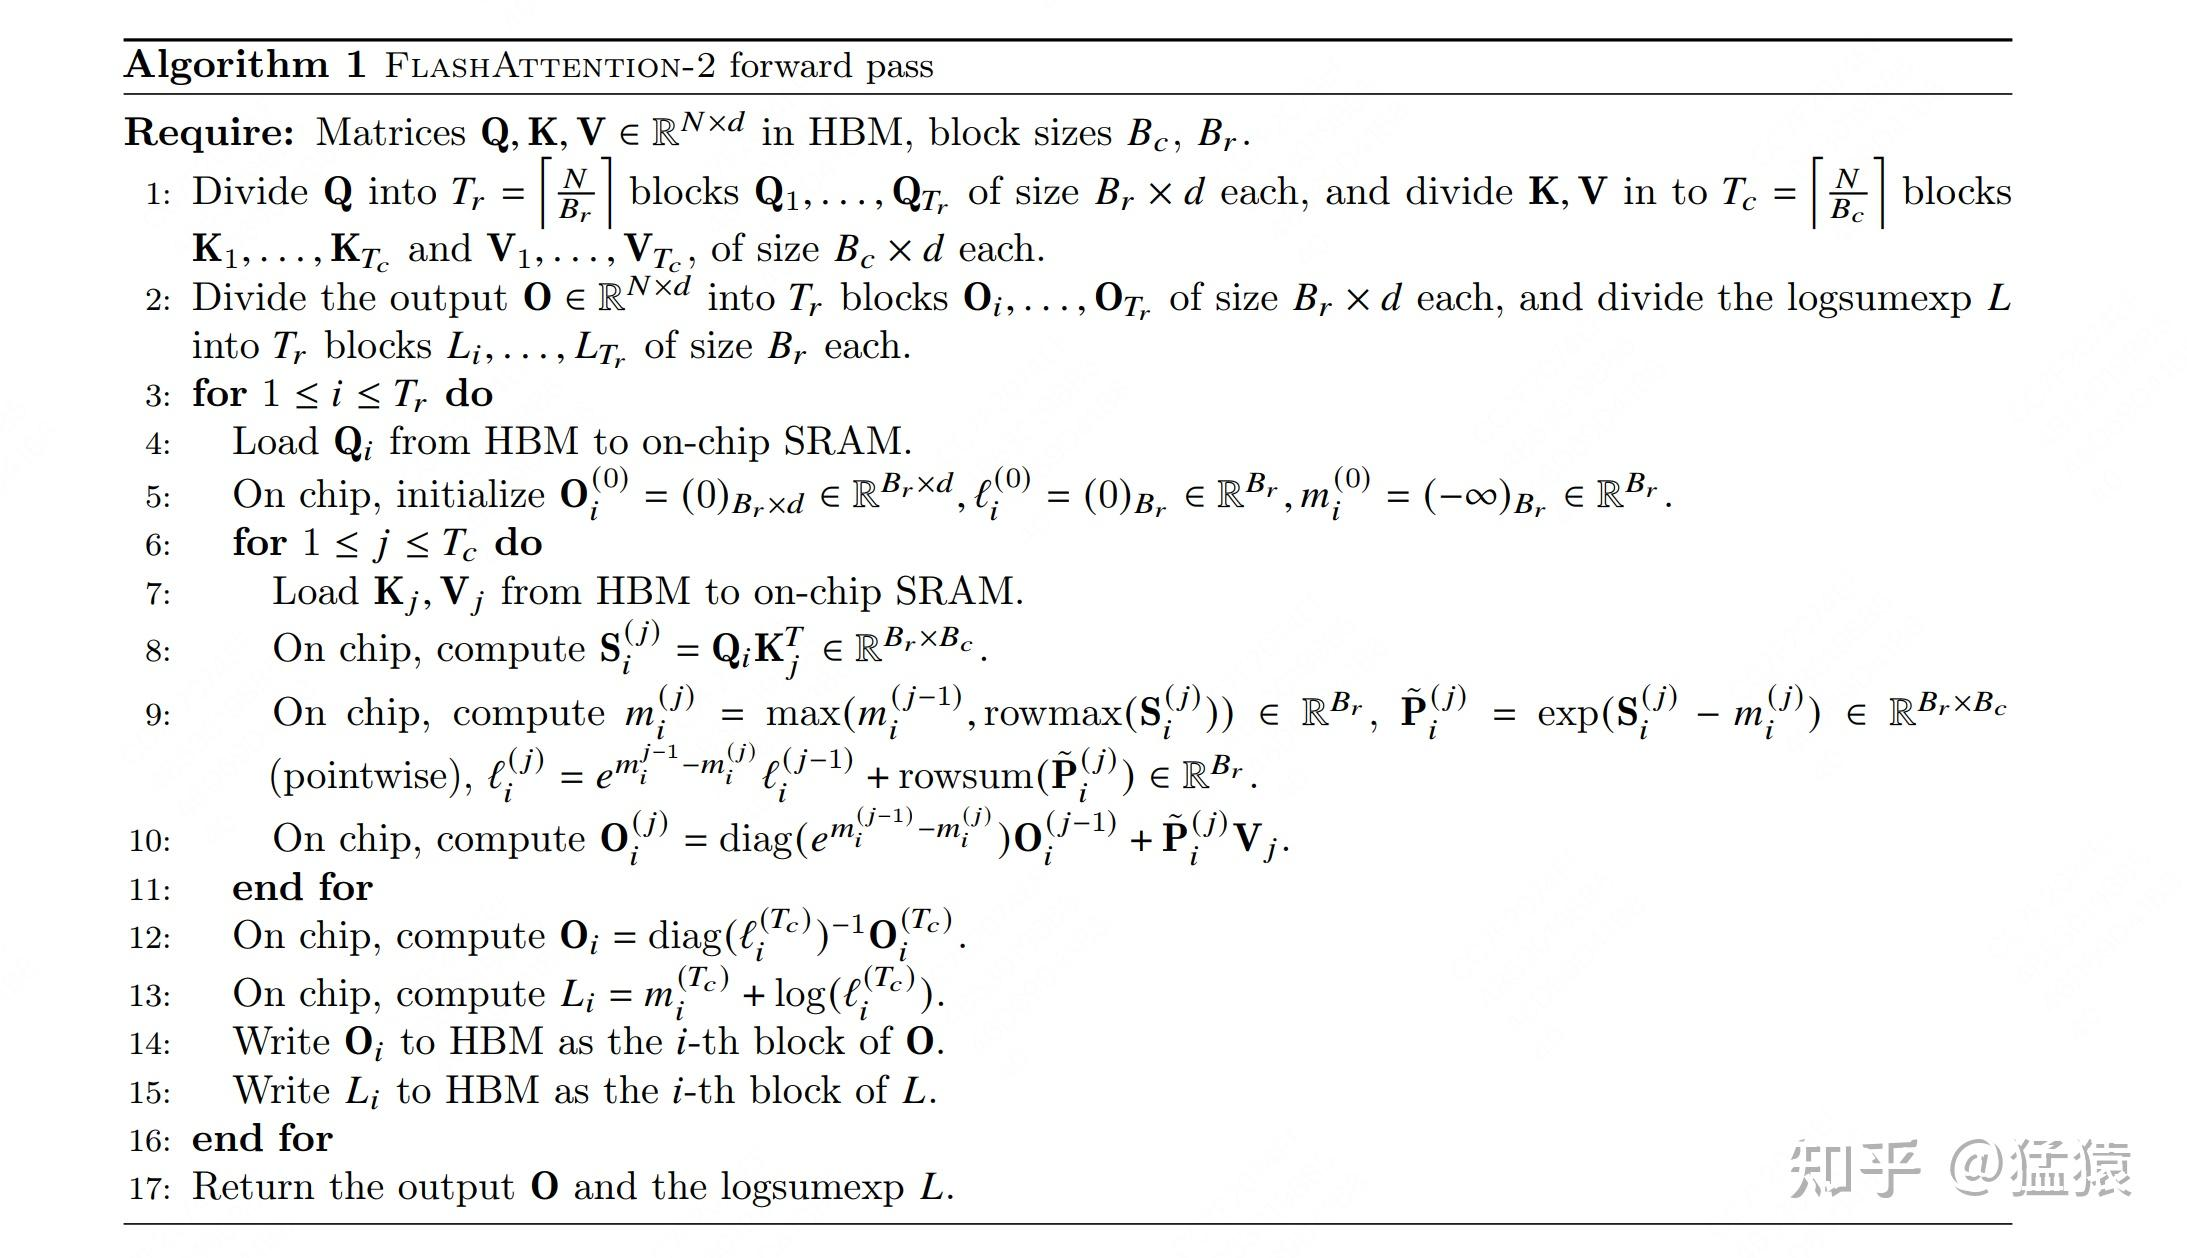
这里也是很复杂,我就把重点写出来
- O的计算中缺少归一化的项$diag(l_i^{(j)})^{-1}$, 这一项放到了第12行做同一计算:尽量减少非矩阵的计算,因为在GPU中,非矩阵计算比矩阵计算慢16倍。
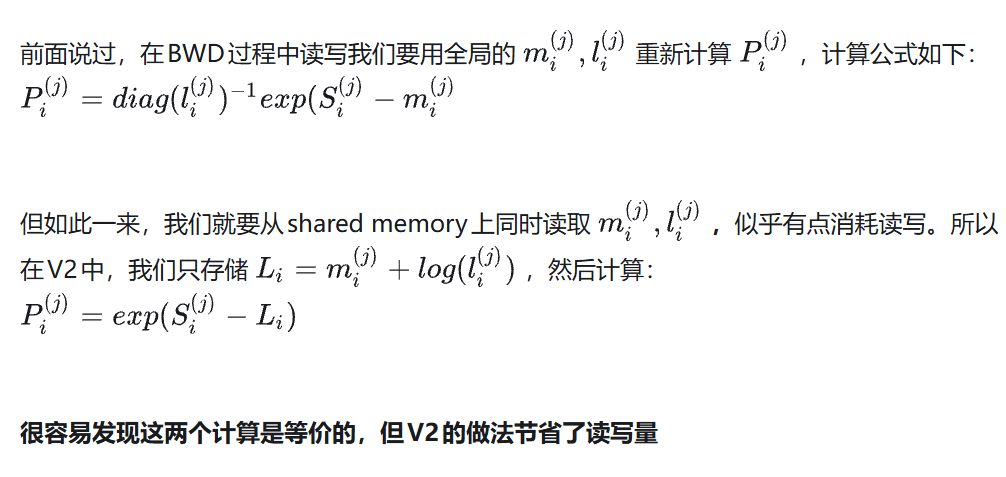
- V2 由于不需要存每一Q分块对应的$m_i | l_i$了,但是再backward中,我们仍然需要它们去做$S_i^{(j)} | P_i^{(j)}$的计算,所以它只存了一个东西:$L_i = m_i^{(T_c)} + log(l_i^{(T_c)})$
backward
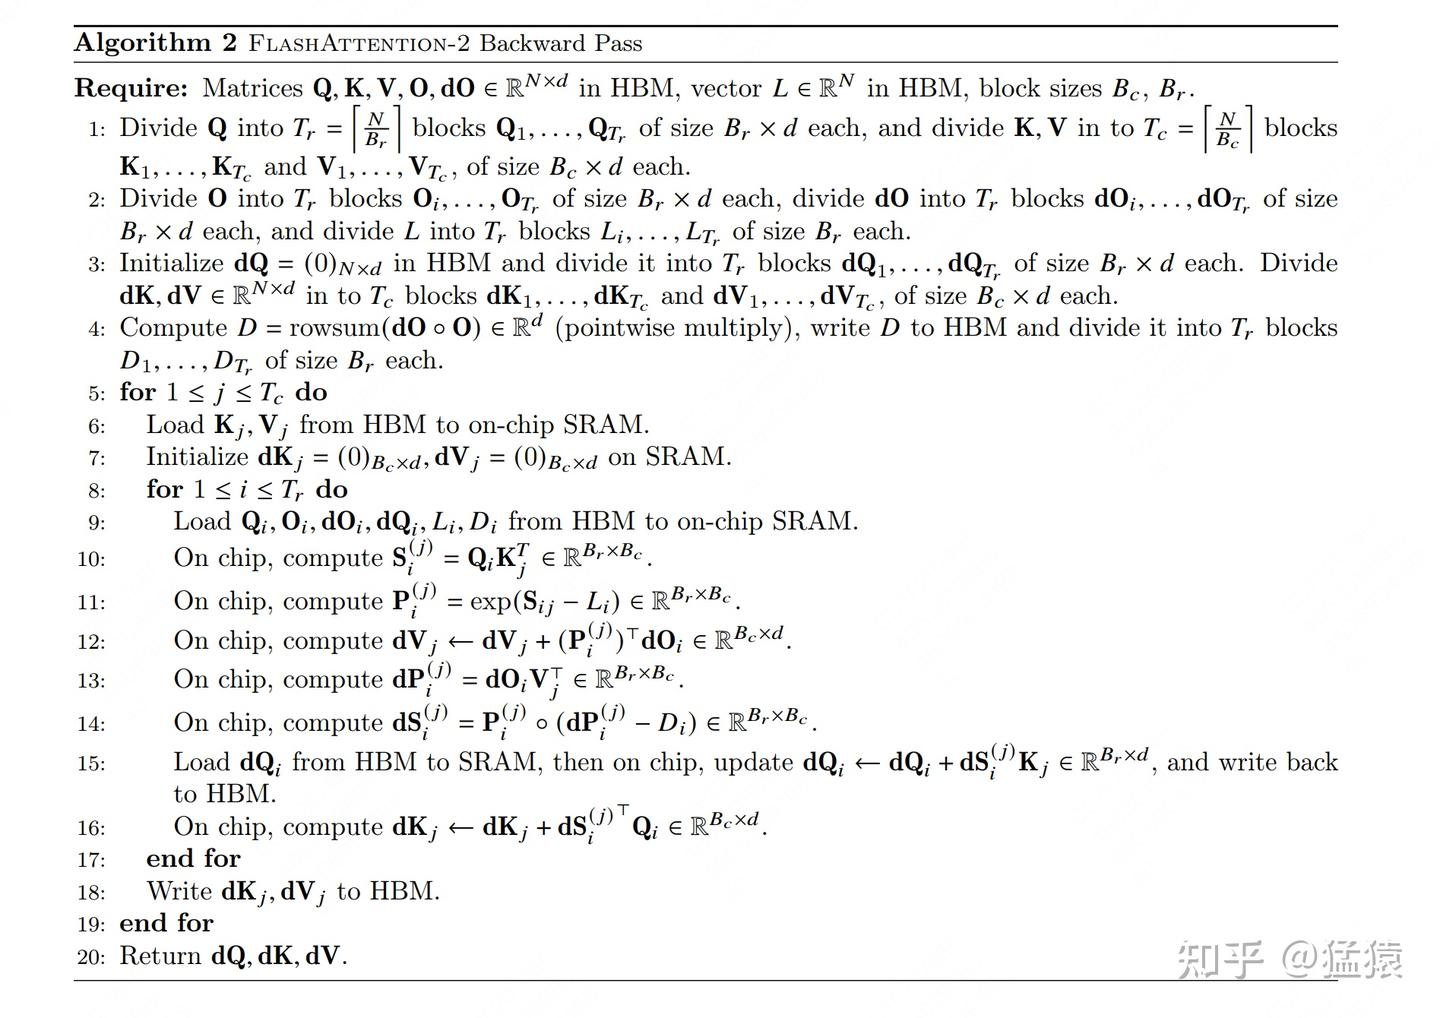
V2相对V1的改进点
总体来说,V2从以下三个方面做了改进:
- 换内外循环位置,同时减少非矩阵的计算量。(这两点我们在第一部分中已给出详细说明)
- 优化Attention部分thread blocks的并行化计算,新增seq_len维度的并行,使SM的利用率尽量打满。这其实也是内外循环置换这个总体思想配套的改进措施
- 优化thread blocks内部warp级别的工作模式,尽量减少warp间的通讯和读取shared memory的次数。
V2中的thread blocks排布
// gridDim in V1
// params.b = batch_size, params.h = num_heads
dim3 grid(params.b, params.h);

// gridDim in V2
const int num_m_block = (params.seqlen_q + Kernel_traits::kBlockM - 1) / Kernel_traits::kBlockM;
dim3 grid(num_m_block, params.b, params.h);
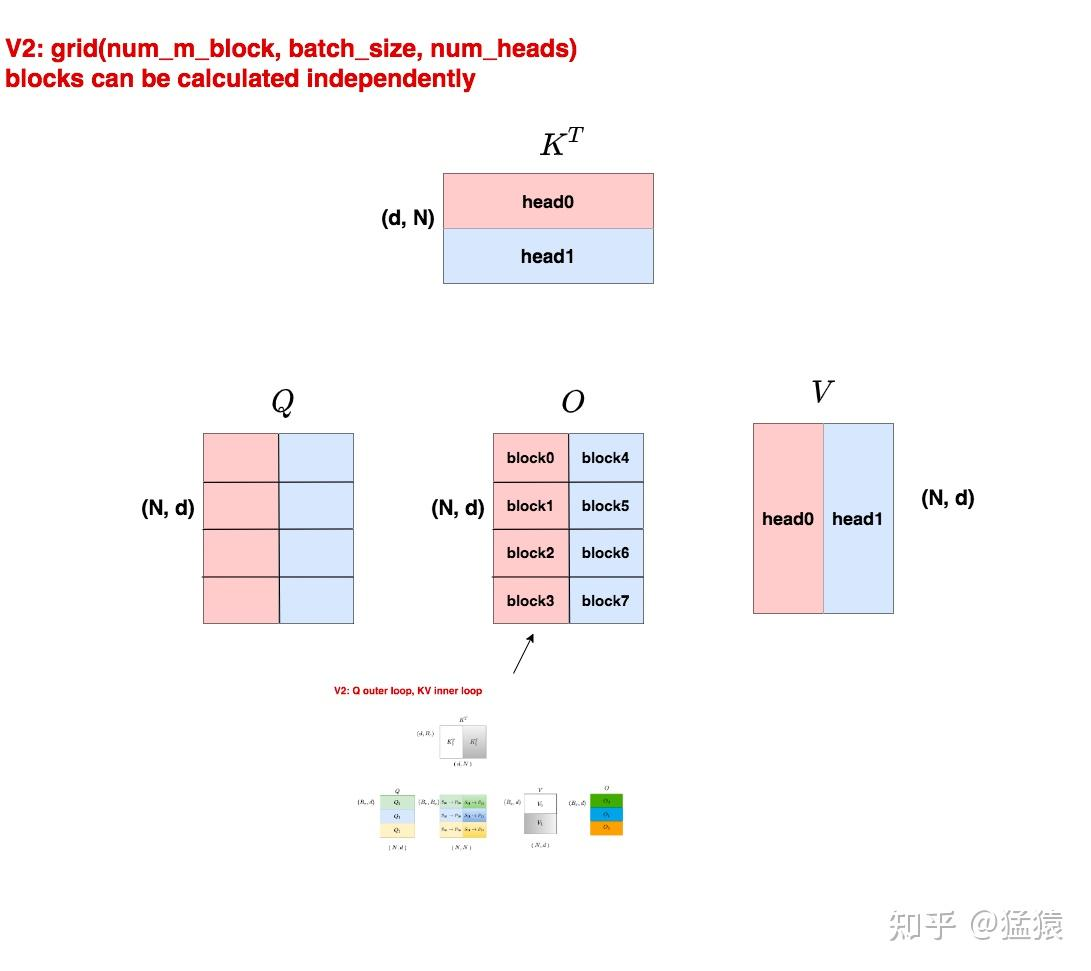
这里细节比较多,比如为什么num_m_blocks放在第一位是为什么?: 这样的调换是为了提升L2 cache hit rate。(虽然block实际执行时不一定按照图中的序号),对于同一列的block,它们读的是KV的相同部分,因此同一列block在读取数据时,有很大概率可以直接从L2 cache上读到自己要的数据(别的block之前取过的)。
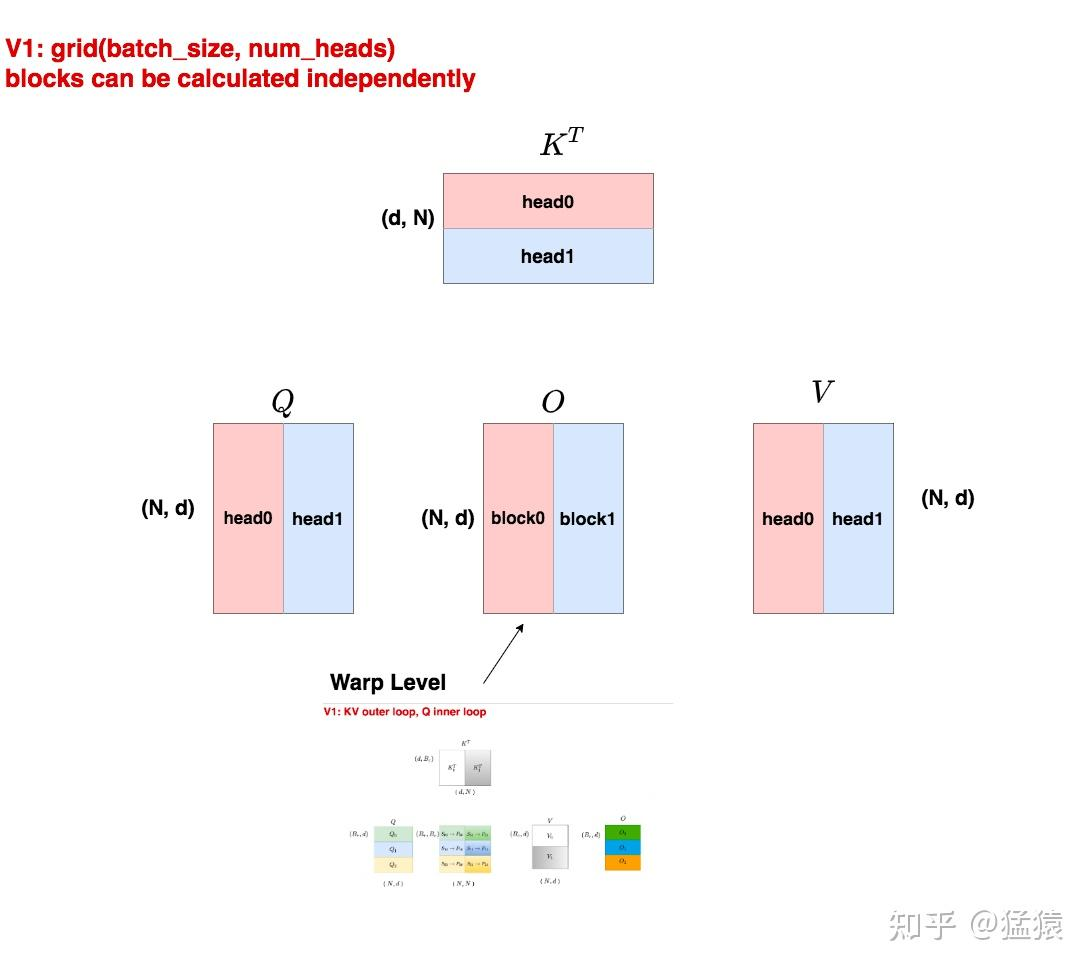
- 在V1中,我们是按batch_size和num_heads来划分block的,也就是说一共有batch_size * num_heads个block,每个block负责计算O矩阵的一部分
- 在V2中,我们是按batch_size,num_heads和num_m_block来划分block的,其中num_m_block可理解成是沿着Q矩阵行方向做的切分。例如Q矩阵行方向长度为seqlen_q(其实就是我们熟悉的输入序列长度seq_len,也就是图例中的N),我们将其划分成num_m_block份,每份长度为kBlockM(也就是每份维护kBlockM个token)。这样就一共有batch_size * num_heads * num_m_block个block,每个block负责计算矩阵O的一部分。
如果我们的数据seq_len比较长,此时往往对应着较小的batch_size和num_heads,这是就会有SM在空转了。而为了解决这个问题,我们就可以引入在Q的seq_len上的划分。
V1 thread block
V2 thread block
Foward和backward中的thread block划分
前几小节中我们其实给出的是FWD过程中thread block的划分方式,我们知道V2中FWD和BWD的内外循环不一致,所以对应来说,thread block的划分也会有所不同,我们详细来看:
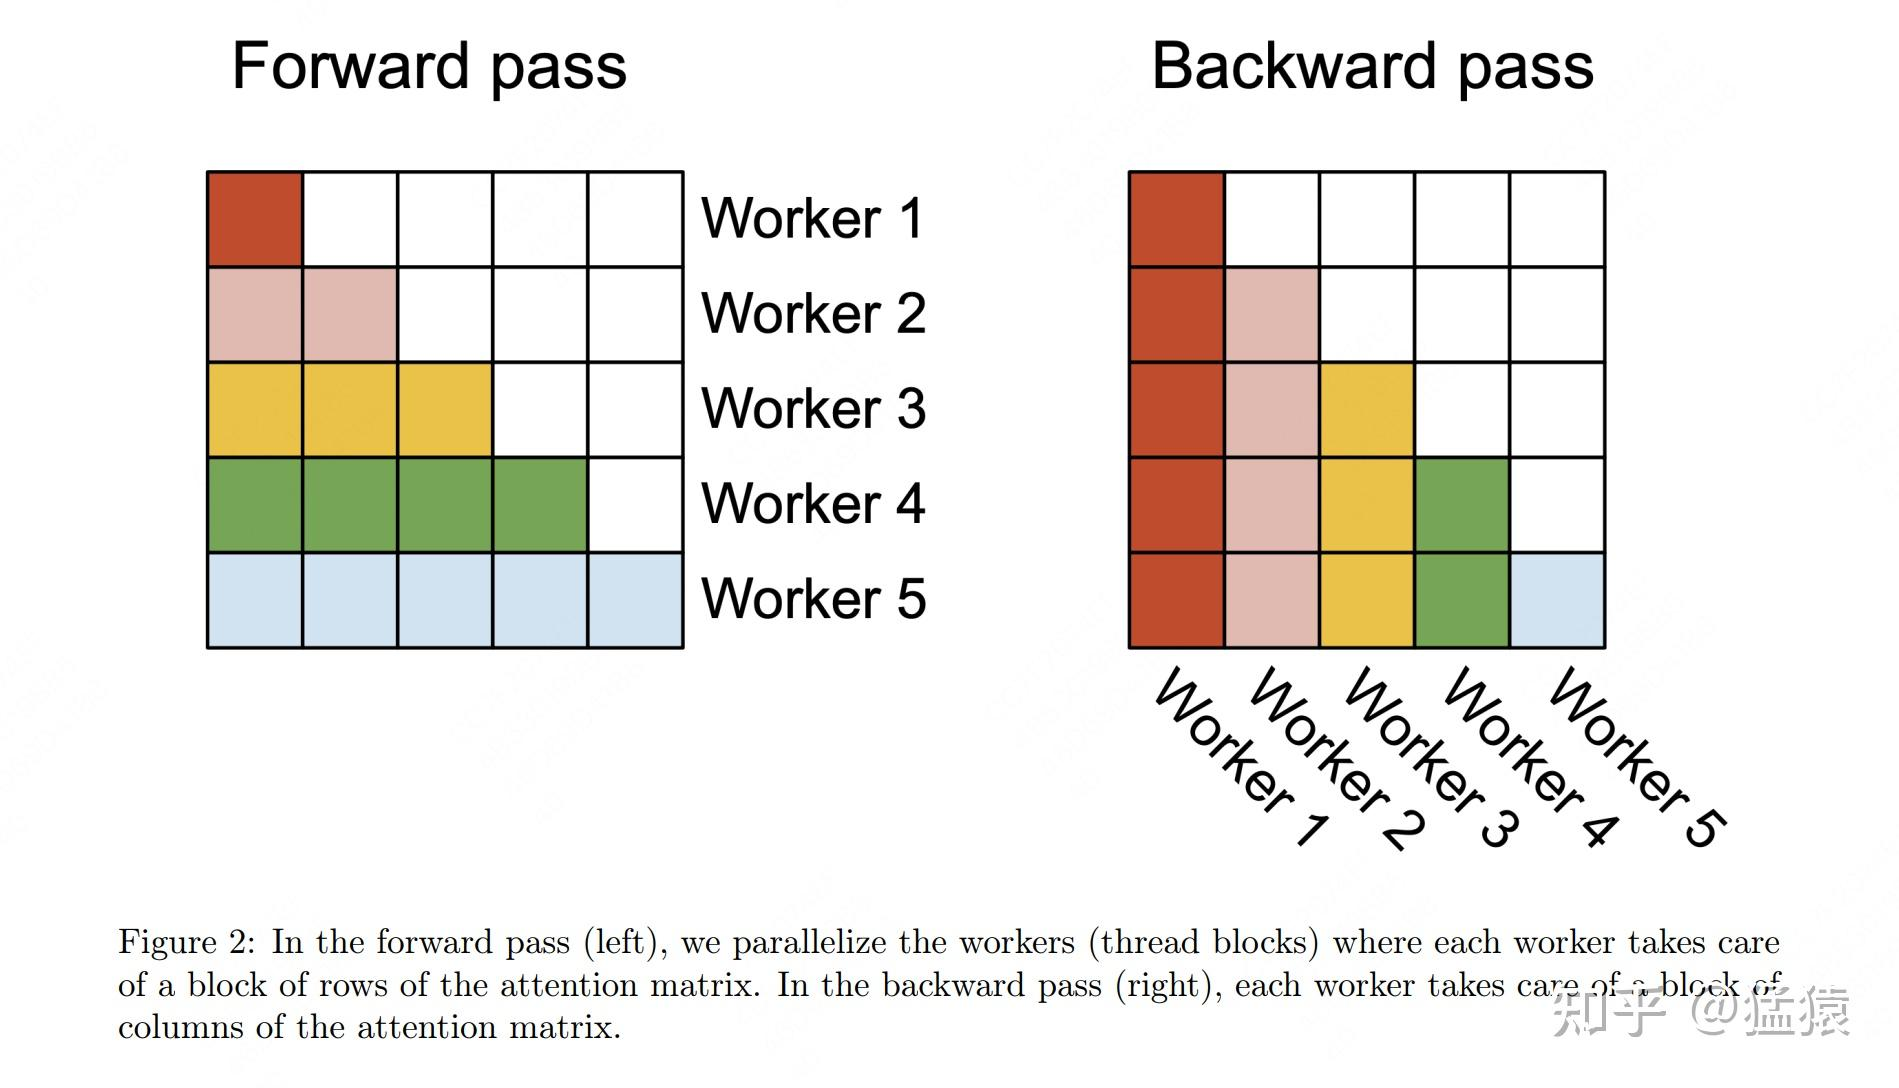
- worker表示thread block,不同的thread block用不同颜色表示
- 整个大方框表示输出矩阵O
我们先看左图,它表示FWD下thread block的结构。每一行都有一个worker,它表示O矩阵的每一行都是由一个thread block计算出来的(假设num_heads = 1),这就对应到我们3.1~3.3中说的划分方式。那么白色的部分表示什么呢?我们知道如果采用的是casual attention,那么有一部分是会被mask掉的,所以这里用白色来表示。但这不意味着thread block不需要加载白色部分数据对应的KV块,只是说在计算的过程中它们会因被mask掉而免于计算(论文中的casual mask一节有提过)。
我们再看右图,它表示BWD下thread block的结构,每一列对应一个worker,这是因为BWD中我们是KV做外循环,Q做内循环,这种情况下dK, dV都是按行累加的,而dQ是按列累加的,少数服从多数,因此这里thread_block是按
的列划分的。
Warp级别并行
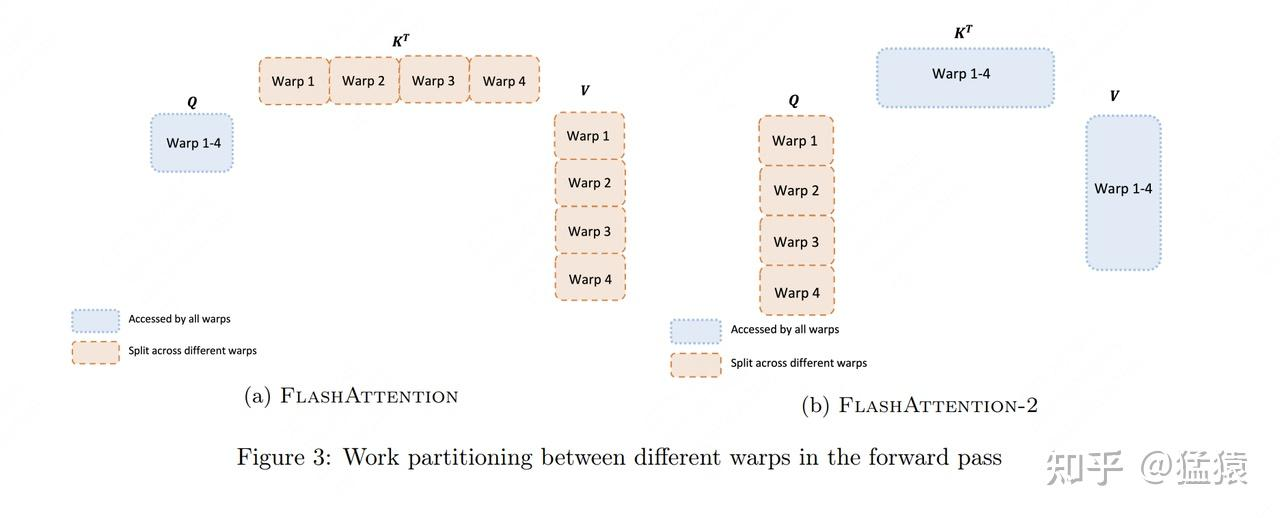
讲完了thread block,我们就可以再下一级,看到warp level级别的并行了。左图表示V1,右图表示V2。不管是V1还是V2,在Ampere架构下,每个block内进一步被划分为4个warp,在Hopper架构下则是8个warp。
在左图(V1)中,每个warp都从shared memory上读取相同的Q块以及自己所负责计算的KV块。在V1中,每个warp只是计算出了列方向上的结果,这些列方向上的结果必须汇总起来,才能得到最终O矩阵行方向上的对应结果。所以每个warp需要把自己算出来的中间结果写到shared memory上,再由一个warp(例如warp1)进行统一的整合。所以各个warp间需要通讯、需要写中间结果,这就影响了计算效率。
在左图(V2)中,每个warp都从shared memory上读取相同的KV块以及自己所负责计算的Q块。在V2中,行方向上的计算是完全独立的,即每个warp把自己计算出的结果写到O的对应位置即可,warp间不需要再做通讯,通过这种方式提升了计算效率。不过这种warp并行方式在V2的BWD过程中就有缺陷了:由于bwd中dK和dV是在行方向上的AllReduce,所以这种切分方式会导致warp间需要通讯。
后记
说实话这里也就是装模做样看懂了,具体内部的实现细节没有那么清楚,但基本的思想其实就那些。