这一节按照ppt完成以下任务,分别是矩阵乘法GEMM的Naive版本,内存合并版本,SMEM分块版本,1D Blocktiling版本,2DBlocktiling版本等等。我感觉还挺恶心的,这个做完我就拿去当我简历上的东西了,直到后面我们完成了FlashAttention的优化。
认真做做吧!
前置芝士
GEMM是计算密集型算子,那么我们怎么论证的呢。
对于计算复杂度,结果矩阵的每个数都会进行一个点积操作O(N),一共有N * N个数,所以计算的总复杂度是$O(N^3)$
对于访存,一共三个矩阵,每个矩阵是O(N^2),所以访存复杂度是$O(N^2)$
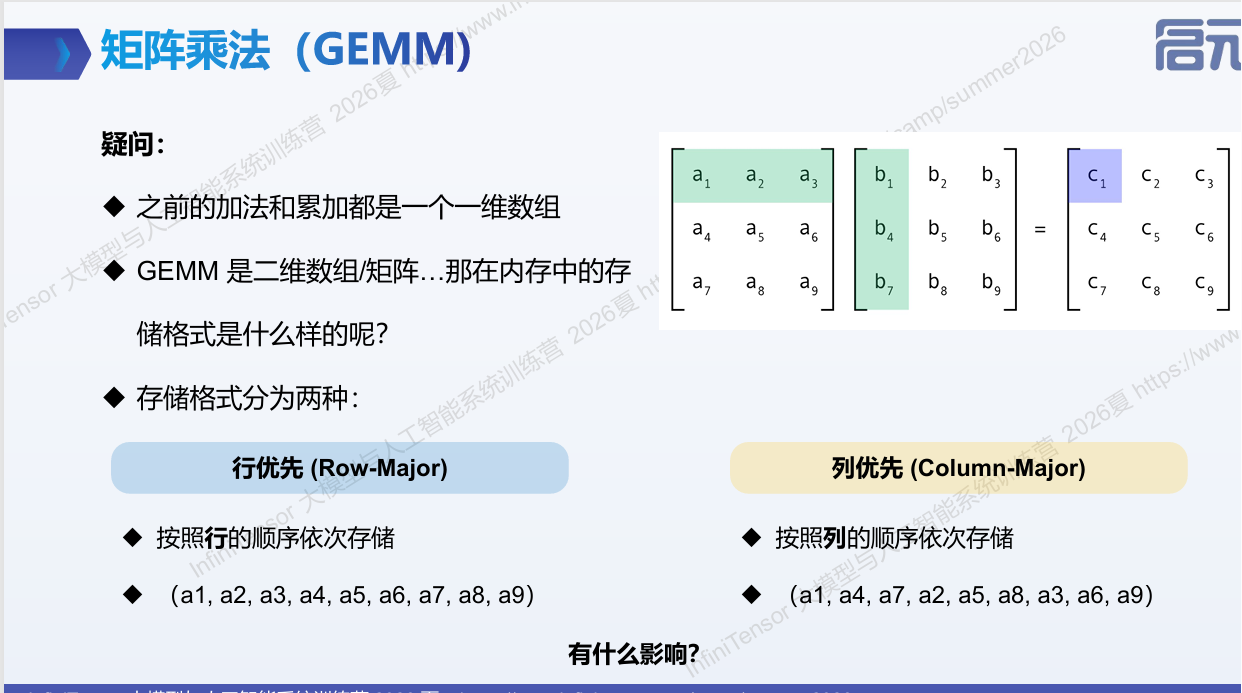
GEMM: $C = \alpha A * B + \beta D$
Naive 版本
#include <iostream>
#include <iomanip>
#include <vector>
#include <cmath>
#include <algorithm>
#include <cstdlib>
#include <cuda_runtime.h>
#include <cstdint>
#include <type_traits>


#define CUDA_CHECK(call) { \
    cudaError_t err = call ;   \
    if (err != cudaSuccess){ \
        std::cerr << "CUDA error at " << __FILE__ << ":" << __LINE__ << ": " \
                  << cudaGetErrorString(err) << '\n'; \
        exit(1); \
    }    \
} \

template <typename T>
__global__ void gemm_naive(int M, int N, int K, float alpha, const T *A, const T *B, float beta, T *C){
    int row = blockIdx.y * blockDim.y + threadIdx.y;
    int col = blockIdx.x * blockDim.x + threadIdx.x;

    if (row < M && col < N) {
        float sum = 0.0f;
        for (int k = 0; k < K; k ++){
            sum += A[row * K + k] * B[k * N + col];
        }
        C[row * N + col] = alpha * sum + beta * C[row * N + col];
    }
}

int main () {
    const int N = 1024;
    const int M = 1024;
    const int K = 512;
    float alpha = 1.3f;
    float beta = 2.1f;
    std::vector<float> h_A_matrix(M*K);
    std::vector<float> h_B_matrix(K*N);

    std::vector<float> ref_C(M*N, 1.0f);
    std::vector<float> ans_C(M*N, 1.0f);

    for (size_t i = 0; i < M; i ++) {
        for (size_t j = 0; j < K; j ++) {
            h_A_matrix[i * K + j] = static_cast<float>(i % 97) - static_cast<float>(j);
        }
    }

    for (size_t i = 0; i < K; i ++) {
        for (size_t j = 0; j < N; j ++) {
            h_B_matrix[i * N + j] = static_cast<float>(i % 53) - static_cast<float>(j);
        }
    }

    for (size_t i = 0; i < M; i ++) {
        for (size_t j = 0; j < N; j ++){
            float sum = 0.0f;
            for (size_t k = 0; k < K; k++)
            {
                sum += h_A_matrix[i*K+k] * h_B_matrix[k*N+j];
            }
            ref_C[i*N+j] = alpha * sum + beta * ref_C[i*N+j];
        }
    }

    float *d_A_matrix = nullptr;
    float *d_B_matrix = nullptr;
    float *d_C = nullptr;
    CUDA_CHECK(cudaMalloc(&d_A_matrix, static_cast<size_t>(M * K * sizeof(float))));
    CUDA_CHECK(cudaMalloc(&d_B_matrix, static_cast<size_t>(K * N * sizeof(float))));
    CUDA_CHECK(cudaMalloc(&d_C, static_cast<size_t>(M * N * sizeof(float))));

    CUDA_CHECK(cudaMemcpy(d_A_matrix, h_A_matrix.data(), static_cast<size_t>(M * K * sizeof(float)), cudaMemcpyHostToDevice));
    CUDA_CHECK(cudaMemcpy(d_B_matrix, h_B_matrix.data(), static_cast<size_t>(K * N * sizeof(float)), cudaMemcpyHostToDevice));
    CUDA_CHECK(cudaMemcpy(d_C, ans_C.data(), static_cast<size_t>(M * N * sizeof(float)), cudaMemcpyHostToDevice));

    unsigned int block_size = 32;
    dim3 block(block_size, block_size);
    unsigned grid_size_x = (N + block.x - 1) / block.x;
    unsigned grid_size_y = (M + block.y - 1) / block.y;
    dim3 grid(grid_size_x, grid_size_y);

    gemm_naive<float><<<grid, block>>> (M, N, K, alpha, d_A_matrix, d_B_matrix, beta, d_C);
    CUDA_CHECK(cudaGetLastError());
    CUDA_CHECK(cudaDeviceSynchronize());

    CUDA_CHECK(cudaMemcpy(ans_C.data(), d_C, M * N * sizeof(float), cudaMemcpyDeviceToHost));

    for (size_t i = 0; i < M; i ++) {
        for (size_t j = 0; j < N; j ++) {
            if (fabs(ref_C[i * N + j] - ans_C[i * N + j]) > 1e-3f * std::max(1.0f, fabs(ref_C[i * N + j]))) {
                std::cerr << "wrong" ;
                exit(1);
            }
        }
    }

    CUDA_CHECK(cudaFree(d_A_matrix));
    CUDA_CHECK(cudaFree(d_B_matrix));
    CUDA_CHECK(cudaFree(d_C));

    std::cout << "passed!\n\n";

    return 0;
}
没什么好讲的,很写到现在已经很简单了
分析:

我们发现sum那一行占据89.55%的动态指令,每次循环需要两次全局内存加载,一次浮点FMA,以及地址计算
当前M * N = 1024^2 = 1048576个元素,每个元素循环512次,所以这行会被执行1024^2 * 512次
注意到左下角的Instruction Mix ,这个表示该源代码生成了哪些类型的SASS指令
我们能够发现对于A,我们同一个warp的32个线程访问同一个元素,可以利用广播和缓存。
Live Registers=37, 这个意思是执行到这个位置时,一个线程大约有37个仍然需要保留其值的寄存器

L2 Theoretical Sectors Global Excessive
表示全局内存访问产生的 L2 sector 数量,相对于理论最少 sector 数量多了多少。
这里接近100%,说明产生了大量额外 sector,通常意味着:
- warp 内地址不连续;
- stride 很大;
- 全局内存访问没有合并。
Warp Stall Sampling
表示采样到的 warp stall 中,有多少可以归因于当前源代码行。
这里我们的结果意味着几乎所有采样到的stall都集中在这一行,常见原因包括:
- 等待全局内存加载;
- scoreboard dependency;
- sum 连续依赖;
- 地址计算依赖。

计算密集型

这里需要注意我们代码的书写逻辑:
template <typename T>
__global__ void gemm_naive(int M, int N, int K, float alpha, const T *A, const T *B, float beta, T *C){
    int row = blockIdx.y * blockDim.y + threadIdx.y;
    int col = blockIdx.x * blockDim.x + threadIdx.x;

    if (row < M && col < N) {
        float sum = 0.0f;
        for (int k = 0; k < K; k ++){
            sum += A[row * K + k] * B[k * N + col];
        }
        C[row * N + col] = alpha * sum + beta * C[row * N + col];
    }
}
为什么我们要这样写?threadIdx.x变化的是要比threadIdx.y快的,blockIdx和gridIdx在这方面也是。这样写的好处是我们在读写A和C时每一行加载数值会变得连续,可以合并。
SMEM缓存版本
通过观察我们可以发现,矩阵中的数据是被复用的,例如计算C里的第一行都用到了A的第一行内容。之前是直接从GMEM里反复读取,这样造成延迟大且浪费资源,于是我们可以通过SMEM来优化,通过SMEM缓存来减少数据复用开销从而提高性能。
const size_t BLOCK_DIM = static_cast<size_t>(1024);

template <typename T>
__global__ void gemm_smem_caching(int M, int N, int K, float alpha, const T *A, const T *B, float beta, T *C){
    __shared__ T As[BLOCK_DIM][BLOCK_DIM] ;
    __shared__ T Bs[BLOCK_DIM][BLOCK_DIM] ;

    int row = blockIdx.y * BLOCK_DIM + threadIdx.y;
    int col = blockIdx.x * BLOCK_DIM + threadIdx.x;

    T tmp = T(0) ;

    int a_row = row;
    int a_col = threadIdx.x;
    As[a_row][a_col] = (a_row < M && a_col < K) ? A[a_row*K+a_col] : T(0);

    int b_row = threadIdx.y;
    int b_col = col;
    Bs[b_row][b_col] = (b_row < K && b_col < N) ? B[b_row*N+b_col] : T(0);

    __syncthreads();

    for (size_t k = 0; k < K; k ++) {
        tmp += As[threadIdx.y][k] * Bs[k][threadIdx.x];
    }
    __syncthreads();

    C[row*N+col] = alpha * tmp + beta * C[row * N + col];
}
发现报错:

发现这里我们需要的空间太大了,超出了SMEM的可分配上限。
很自然的我们想到了分块(tiling)的思想,每次仅从GMEM加载一块(Tile)到SMEM,然后计算这部分的数据。
const size_t BLOCK_DIM = static_cast<size_t>(32);

template <typename T>
__global__ void gemm_smem_caching(int M, int N, int K, float alpha, const T *A, const T *B, float beta, T *C){
    __shared__ T As[BLOCK_DIM][BLOCK_DIM] ;
    __shared__ T Bs[BLOCK_DIM][BLOCK_DIM] ;

    int row = blockIdx.y * BLOCK_DIM + threadIdx.y;
    int col = blockIdx.x * BLOCK_DIM + threadIdx.x;

    T tmp = T(0) ;

    for (size_t bk = 0; bk < K; bk += BLOCK_DIM){
        int a_row = row;
        int a_col = bk + threadIdx.x;
        As[threadIdx.y][threadIdx.x] = (a_row < M && a_col < K) ? A[a_row*K+a_col] : T(0);

        int b_row = bk + threadIdx.y;
        int b_col = col;
        Bs[threadIdx.y][threadIdx.x] = (b_row < K && b_col < N) ? B[b_row*N+b_col] : T(0);

        __syncthreads();

        for (size_t k = 0; k < BLOCK_DIM; k ++) {
            tmp += As[threadIdx.y][k] * Bs[k][threadIdx.x];
        }
        __syncthreads();
    }


    if (row < M && col < N) {
        C[row*N+col] = alpha * tmp + beta * C[row * N + col];
    }
}

Warp很多都在等待SMEM(使用过于频繁)
1D Blocktiling

回顾一下我之前的GEMM代码,它一个线程负责计算C矩阵中的1个元素,每个线程只有一个累加器tmp,每个线程不断从Shared Memory中加载A、B的数据。
而现在我们这样操作,让一个线程同时计算C矩阵同一列中的’THREAD_M’个元素,从而复用从Shared Memory中读取的B元素。
#include <iostream>
#include <iomanip>
#include <vector>
#include <cmath>
#include <algorithm>
#include <cstdlib>
#include <cuda_runtime.h>
#include <cstdint>
#include <type_traits>


#define CUDA_CHECK(call) { \
    cudaError_t err = call ;   \
    if (err != cudaSuccess){ \
        std::cerr << "CUDA error at " << __FILE__ << ":" << __LINE__ << ": " \
                  << cudaGetErrorString(err) << '\n'; \
        exit(1); \
    }    \
} \

const size_t BLOCK_DIM = static_cast<size_t>(32);
constexpr int THREAD_M = 4;

template <typename T>
__global__ void gemm_smem_caching(int M, int N, int K, float alpha, const T *A, const T *B, float beta, T *C){
    __shared__ T As[BLOCK_DIM][BLOCK_DIM] ;
    __shared__ T Bs[BLOCK_DIM][BLOCK_DIM] ;

    int tx = threadIdx.x;
    int ty = threadIdx.y;

    int rowStart = blockIdx.y * BLOCK_DIM + threadIdx.y * THREAD_M;
    int col = blockIdx.x * BLOCK_DIM + threadIdx.x;

    T accum[THREAD_M] = {T(0)};

    for (int bk = 0; bk < K; bk += BLOCK_DIM){
        for (int i = 0; i < THREAD_M; i ++) {
            int localRow = ty * THREAD_M + i;
            int aRow = blockIdx.y * BLOCK_DIM + localRow;
            int aCol = bk + tx;
            As[localRow][tx] = (aRow < M && aCol < K) ? A[aRow*K+aCol] : T(0);

            int bRow = bk + localRow;
            int bCol = col;
            Bs[localRow][tx] = (bRow < K && bCol < N) ? B[bRow*N+bCol] : T(0);
        }

        __syncthreads();

        for (int k = 0; k < BLOCK_DIM; k ++) {
            T bVal = Bs[k][tx];

            #pragma unroll
            for (int i = 0; i < THREAD_M; i ++) {
                int aRow = ty * THREAD_M + i;
                T aVal = As[aRow][k];

                accum[i] += aVal * bVal;
            }
        }

        __syncthreads();
    }

    for (int i = 0; i < THREAD_M; i++) {
        int row = rowStart + i;

        if (row < M && col < N) {
            int idx = row * N + col;

            C[idx] = static_cast<T>(
                alpha * accum[i] + beta * C[idx]
            );
        }
    }
}


int main () {
    const int N = 1024;
    const int M = 1024;
    const int K = 512;
    float alpha = 1.3f;
    float beta = 2.1f;
    std::vector<float> h_A_matrix(M*K);
    std::vector<float> h_B_matrix(K*N);

    std::vector<float> ref_C(M*N, 1.0f);
    std::vector<float> ans_C(M*N, 1.0f);

    for (size_t i = 0; i < M; i ++) {
        for (size_t j = 0; j < K; j ++) {
            h_A_matrix[i * K + j] = static_cast<float>(i % 97) - static_cast<float>(j);
        }
    }

    for (size_t i = 0; i < K; i ++) {
        for (size_t j = 0; j < N; j ++) {
            h_B_matrix[i * N + j] = static_cast<float>(i % 53) - static_cast<float>(j);
        }
    }

    for (size_t i = 0; i < M; i ++) {
        for (size_t j = 0; j < N; j ++){
            float sum = 0.0f;
            for (size_t k = 0; k < K; k++)
            {
                sum += h_A_matrix[i*K+k] * h_B_matrix[k*N+j];
            }
            ref_C[i*N+j] = alpha * sum + beta * ref_C[i*N+j];
        }
    }

    float *d_A_matrix = nullptr;
    float *d_B_matrix = nullptr;
    float *d_C = nullptr;
    CUDA_CHECK(cudaMalloc(&d_A_matrix, static_cast<size_t>(M * K * sizeof(float))));
    CUDA_CHECK(cudaMalloc(&d_B_matrix, static_cast<size_t>(K * N * sizeof(float))));
    CUDA_CHECK(cudaMalloc(&d_C, static_cast<size_t>(M * N * sizeof(float))));

    CUDA_CHECK(cudaMemcpy(d_A_matrix, h_A_matrix.data(), static_cast<size_t>(M * K * sizeof(float)), cudaMemcpyHostToDevice));
    CUDA_CHECK(cudaMemcpy(d_B_matrix, h_B_matrix.data(), static_cast<size_t>(K * N * sizeof(float)), cudaMemcpyHostToDevice));
    CUDA_CHECK(cudaMemcpy(d_C, ans_C.data(), static_cast<size_t>(M * N * sizeof(float)), cudaMemcpyHostToDevice));

    unsigned int block_size = 32;
    dim3 block(block_size, block_size/static_cast<unsigned int>(THREAD_M));
    unsigned grid_size_x = (N + block.x - 1) / block_size;
    unsigned grid_size_y = (M + block.y - 1) / block_size;
    dim3 grid(grid_size_x, grid_size_y);

    gemm_smem_caching<float><<<grid, block>>> (M, N, K, alpha, d_A_matrix, d_B_matrix, beta, d_C);
    CUDA_CHECK(cudaGetLastError());
    CUDA_CHECK(cudaDeviceSynchronize());

    CUDA_CHECK(cudaMemcpy(ans_C.data(), d_C, M * N * sizeof(float), cudaMemcpyDeviceToHost));

    for (size_t i = 0; i < M; i ++) {
        for (size_t j = 0; j < N; j ++) {
            if (fabs(ref_C[i * N + j] - ans_C[i * N + j]) > 1e-3f * std::max(1.0f, fabs(ref_C[i * N + j]))) {
                std::cerr << "wrong" ;
                exit(1);
            }
        }
    }

    CUDA_CHECK(cudaFree(d_A_matrix));
    CUDA_CHECK(cudaFree(d_B_matrix));
    CUDA_CHECK(cudaFree(d_C));

    std::cout << "passed!\n\n";

    return 0;
}
我来梳理一下这里面的逻辑:
理论
我们规定一个CUDA Block负责计算C中的一个32*32 的区域
现在我们希望一个线程同时计算同一列的4个连续元素
例如对于线程(tx = 3, ty = 2)不再只计算C[2][3],而是计算当前Tile内的:C[8][3],C[9][3],C[10][3],C[11][3],这也能解释代码中的:
int localRow = ty * THREAD_M + i;
既然一个线程计算4个元素,那每个线程就需要4个累加器accum[THREAD_M],这四个累加器分别对应上面的C.
由于每个线程现在计算4个输出,那么总共只需要32 * 32 / 4 = 256个线程 。
这里需要注意,在x方向我们希望一个线程负责一列,在y方向,一个线程负责四行。
这里需要详细说一下Shared Memory部分。首先我们思考,我需要加载什么数据,才能计算当前的32*32 C tile。很自然的A,B,C都是32*32,所以我们需要填充:
__shared__ T As[32][32];
__shared__ T Bs[32][32];
一个Block只有256个线程,而As,Bs分别有1024个元素,所以一个线程必须承担4个As和4个Bs元素的加载任务。
对于固定的tx,8个不同的ty分别负责行0-31。
代码中aRow,aCol分别代表A中的全局行和列。这里都很好理解。但可以更抽象的去理解这个全局坐标是怎么看的:
$$\begin{equation}
\boxed{
\begin{aligned}
A &: \quad (blockRow+r,\ bk+c)\\
B &: \quad (bk+r,\ blockCol+c)
\end{aligned}
}
\end{equation}$$
这里我理解不清楚的地方在于为什么我只算了k的0~31就能够说明C的值,这里需要注意我们的for循环嵌套,我们实际上就是取了A的THREAD_M整行和B的THREAD_M整列,请注意这个。
2D Blocktiling

#include <iostream>
#include <iomanip>
#include <vector>
#include <cmath>
#include <algorithm>
#include <cstdlib>
#include <cuda_runtime.h>
#include <cstdint>
#include <type_traits>


#define CUDA_CHECK(call) { \
    cudaError_t err = call ;   \
    if (err != cudaSuccess){ \
        std::cerr << "CUDA error at " << __FILE__ << ":" << __LINE__ << ": " \
                  << cudaGetErrorString(err) << '\n'; \
        exit(1); \
    }    \
} \

const size_t BLOCK_DIM = static_cast<size_t>(32);
constexpr int THREAD_M = 4;
constexpr int THREAD_N = 4;

template <typename T>
__global__ void gemm_smem_caching(int M, int N, int K, float alpha, const T *A, const T *B, float beta, T *C){
    __shared__ T As[BLOCK_DIM][BLOCK_DIM] ;
    __shared__ T Bs[BLOCK_DIM][BLOCK_DIM] ;

    int tx = threadIdx.x;
    int ty = threadIdx.y;

    int rowStart = blockIdx.y * BLOCK_DIM + threadIdx.y * THREAD_M;
    int colStart = blockIdx.x * BLOCK_DIM + threadIdx.x * THREAD_N;

    T accum[THREAD_M][THREAD_N] = {T(0)};

    int tid = ty * blockDim.x + tx;
    int numThreads = blockDim.x * blockDim.y;

    for (int bk = 0; bk < K; bk += BLOCK_DIM){
        for (int idx = tid; idx < BLOCK_DIM * BLOCK_DIM; idx += numThreads) {

            int r = idx / BLOCK_DIM;
            int c = idx % BLOCK_DIM;

            int aRow = blockIdx.y * BLOCK_DIM + r;
            int aCol = bk + c;
            As[r][c] = (aRow < M && aCol < K) ? A[aRow*K+aCol] : T(0);

            int bRow = bk + r;
            int bCol = blockIdx.x * BLOCK_DIM + c;
            Bs[r][c] = (bRow < K && bCol < N) ? B[bRow*N+bCol] : T(0);
        }

        __syncthreads();

        for (int k = 0; k < BLOCK_DIM; k ++) {
            T A_reg[THREAD_M];
            T B_reg[THREAD_N];

            #pragma unroll
            for (int i = 0; i < THREAD_M; i ++) {
                int aRow = ty * THREAD_M + i;
                A_reg[i] = As[aRow][k];
            }

            #pragma unroll
            for (int j = 0; j < THREAD_N; j ++) {
                int bCol = tx * THREAD_N + j;
                B_reg[j] = Bs[k][bCol];
            }

            #pragma unroll
            for (int i = 0; i < THREAD_M; i ++) {
                for ( int j = 0; j < THREAD_N; j ++) {
                    accum[i][j] += A_reg[i] * B_reg[j];
                }
            }
        }

        __syncthreads();
    }

    for (int i = 0; i < THREAD_M; i ++) {
        for ( int j = 0; j < THREAD_N; j ++) {
            int row = rowStart + i;
            int col = colStart + j;

            if (row < M && col < N) {
                int index = row * N + col;

                C[index] = static_cast<T>(alpha * accum[i][j] + beta * C[index]);
            }
        }
    }
}


int main () {
    const int N = 1024;
    const int M = 1024;
    const int K = 512;
    float alpha = 1.3f;
    float beta = 2.1f;
    std::vector<float> h_A_matrix(M*K);
    std::vector<float> h_B_matrix(K*N);

    std::vector<float> ref_C(M*N, 1.0f);
    std::vector<float> ans_C(M*N, 1.0f);

    for (size_t i = 0; i < M; i ++) {
        for (size_t j = 0; j < K; j ++) {
            h_A_matrix[i * K + j] = static_cast<float>(i % 97) - static_cast<float>(j);
        }
    }

    for (size_t i = 0; i < K; i ++) {
        for (size_t j = 0; j < N; j ++) {
            h_B_matrix[i * N + j] = static_cast<float>(i % 53) - static_cast<float>(j);
        }
    }

    for (size_t i = 0; i < M; i ++) {
        for (size_t j = 0; j < N; j ++){
            float sum = 0.0f;
            for (size_t k = 0; k < K; k++)
            {
                sum += h_A_matrix[i*K+k] * h_B_matrix[k*N+j];
            }
            ref_C[i*N+j] = alpha * sum + beta * ref_C[i*N+j];
        }
    }

    float *d_A_matrix = nullptr;
    float *d_B_matrix = nullptr;
    float *d_C = nullptr;
    CUDA_CHECK(cudaMalloc(&d_A_matrix, static_cast<size_t>(M * K * sizeof(float))));
    CUDA_CHECK(cudaMalloc(&d_B_matrix, static_cast<size_t>(K * N * sizeof(float))));
    CUDA_CHECK(cudaMalloc(&d_C, static_cast<size_t>(M * N * sizeof(float))));

    CUDA_CHECK(cudaMemcpy(d_A_matrix, h_A_matrix.data(), static_cast<size_t>(M * K * sizeof(float)), cudaMemcpyHostToDevice));
    CUDA_CHECK(cudaMemcpy(d_B_matrix, h_B_matrix.data(), static_cast<size_t>(K * N * sizeof(float)), cudaMemcpyHostToDevice));
    CUDA_CHECK(cudaMemcpy(d_C, ans_C.data(), static_cast<size_t>(M * N * sizeof(float)), cudaMemcpyHostToDevice));

    unsigned int block_size = 32;
    dim3 block(block_size/static_cast<unsigned int>(THREAD_N), block_size/static_cast<unsigned int>(THREAD_M));
    unsigned grid_size_x = (N + block.x - 1) / block_size;
    unsigned grid_size_y = (M + block.y - 1) / block_size;
    dim3 grid(grid_size_x, grid_size_y);

    gemm_smem_caching<float><<<grid, block>>> (M, N, K, alpha, d_A_matrix, d_B_matrix, beta, d_C);
    CUDA_CHECK(cudaGetLastError());
    CUDA_CHECK(cudaDeviceSynchronize());

    CUDA_CHECK(cudaMemcpy(ans_C.data(), d_C, M * N * sizeof(float), cudaMemcpyDeviceToHost));

    for (size_t i = 0; i < M; i ++) {
        for (size_t j = 0; j < N; j ++) {
            if (fabs(ref_C[i * N + j] - ans_C[i * N + j]) > 1e-3f * std::max(1.0f, fabs(ref_C[i * N + j]))) {
                std::cerr << "wrong" ;
                exit(1);
            }
        }
    }

    CUDA_CHECK(cudaFree(d_A_matrix));
    CUDA_CHECK(cudaFree(d_B_matrix));
    CUDA_CHECK(cudaFree(d_C));

    std::cout << "passed!\n\n";

    return 0;
}
昨天匆匆忙忙的写完了代码,但是代码里面很多细节我其实没有那么清楚,今天仔细研究一下。
现在我开始对于1d和2d的优化逻辑进行总结
小结
1D 和 2Dblock tiling本质是让一个线程计算多个C元素,从而把shared memory中读出的数据继续放进寄存器并重复使用。
优点是:1.能够减少shared-memory读取次数,2.降低地址计算,循环控制等指令占比,3.增加相互独立的FMA,隐藏指令延迟,4.减少线程数量和调度开销。
我们一个个的看:
Naive
对于naive GEMM,我们每次循环读取一个A和一个B,执行一次FMA,一次FMA计算A * B + sum,这算作2个FLOP,读取2个float,所以:
2 FLOP / 8 byte = 0.25 FLOP/byte
Shared Memory
对于shared memory tiling,每轮加载A tile:32 * 32, B tile: 32 * 32, 然后计算 C tile: 32 * 32,总的流量为:(32 * 32 + 32 * 32) * 4 byte = 8192byte, 计算的次数为:32 * 32 * 32 * 2 = 65536 FLOP, 所以$AI = \frac{65536}{8192} = 8 FLOP/byte$。但是可以主义党,这个方案每个线程只计算一个输出元素,shared memory中的数据还没有充分利用寄存器复用。
1D block tiling
对于1D block tiling,我们每个线程计算纵向的4个输出,例如一个线程计算:
C[row + 0][col]
C[row + 1][col]
C[row + 2][col]
C[row + 3][col]
代码里面我们可以看到,bVal只从shared memory读取一次,却参与4次FMA,可以得知,1d tiling主要复用的是B。
对于这个方案的每次k,我们每个线程读取4个A,1个B,执行4个FMA。这样说还是很抽象,回过头来,为什么我们要设计1D block tiling,我们的目的是解决warp等待SMEM的问题,我们实际上并没有减少计算量,也没有减少每个Block从Global Memory加载的数据量,但是它减少了Shared Memory的重复读取,提高了寄存器的复用,增加了指令级并行。
指令级并行是什么意思,原版的代码:
tmp += As[ty][0] * Bs[0][tx];
tmp += As[ty][1] * Bs[1][tx];
tmp += As[ty][2] * Bs[2][tx];
后一次累加前一次的tmp。
而我们的1D拥有4个累加器。
2D block tiling
FMA:读取4个A,4个B,执行16个FMA。其它逻辑差不多。
Warp Tiling
理论
我们假设:
- 一个 thread block 负责一个 BM×BN 的 C tile;
- block 中的每个 warp 负责一个 WM×WN 的 C tile;
- warp 中的每个 lane 负责一个 TM×TN 的 thread tile;
- thread tile 的结果保存在该线程的寄存器中。
那么一个warp tile中thread tile的数量必须恰好等于32
(WM / TM) × (WN / TN) == 32
一个block中warp数量为:
NUM_WARPS = (BM / WM) × (BN / WN)
block中线程数量为:
NUM_THREADS = NUM_WARPS × 32
它的作用是建立更清晰的层级,使得可以系统控制,比如:
- 每个 block 从 global memory 加载哪些 A、B 元素;
- 每个 warp 从 shared memory 消费哪些 A、B 数据;
- 每个线程在寄存器中保存多少个 C 元素;
- shared memory 到寄存器的数据复用次数;
- 一个 warp 内的访问是否连续、广播或产生 Bank Conflict;
- 后续如何加入 float4、双缓冲和 cp.async。
代码
#include <iostream>
#include <iomanip>
#include <vector>
#include <cmath>
#include <algorithm>
#include <cstdlib>
#include <cuda_runtime.h>
#include <cstdint>
#include <type_traits>


#define CUDA_CHECK(call) { \
    cudaError_t err = call ;   \
    if (err != cudaSuccess){ \
        std::cerr << "CUDA error at " << __FILE__ << ":" << __LINE__ << ": " \
                  << cudaGetErrorString(err) << '\n'; \
        exit(1); \
    }    \
} \

constexpr int BM = 64;
constexpr int BN = 64;
constexpr int BK = 8;

constexpr int WM = 32;
constexpr int WN = 32;

constexpr int TM = 8;
constexpr int TN = 4;

constexpr int NUM_WARPS_M = BM / WM;
constexpr int NUM_WARPS_N = BN / WN;
constexpr int NUM_WARPS = NUM_WARPS_M * NUM_WARPS_N;
constexpr int NUM_THREADS = NUM_WARPS * 32;

static_assert(BM % WM == 0);
static_assert(BN % WN == 0);
static_assert(WM % TM == 0);
static_assert(WN % TN == 0);
static_assert((WM / TM) * (WN / TN) == 32);

template <typename T>
__global__ void gemm_warptiling(int M, int N, int K, float alpha, const T *A, const T *B, float beta, T *C){
    __shared__ T As[BM][BK];
    __shared__ T Bs[BK][BN];

    int tid = threadIdx.x;
    int warpId = tid / 32;
    int laneId = tid % 32;

    int warpRow = warpId / NUM_WARPS_N;
    int warpCol = warpId % NUM_WARPS_N;

    constexpr int THREAD_TILES_N = WN / TN;
    int laneRow = laneId / THREAD_TILES_N;
    int laneCol = laneId % THREAD_TILES_N;

    int threadRowBase = warpRow * WM + laneRow * TM;
    int threadColBase = warpCol * WN + laneCol * TN;

    T accum[TM][TN] = {T(0)};

    for (int bk = 0; bk < K; bk += BK) {
        for (int idx = tid; idx < BM * BK; idx += NUM_THREADS) {
            int localRow = idx / BK;
            int localK = idx % BK;

            int globalRow = blockIdx.y * BM + localRow;
            int globalK = bk + localK;

            As[localRow][localK] = (globalRow < M && globalK < K) ? A[globalRow * K + globalK] : T(0);
        }

        for (int idx = tid; idx < BK * BN; idx += NUM_THREADS) {
            int localK = idx / BN;
            int localCol = idx % BN;

            int globalK = bk + localK;
            int globalCol = blockIdx.x * BN + localCol;

            Bs[localK][localCol] = (globalK < K && globalCol < N) ? B[globalK * N + globalCol] : T(0);
        }

        __syncthreads();

        #pragma unroll
        for (int localK = 0; localK < BK; localK ++) {
            T A_reg[TM];
            T B_reg[TN];

            #pragma unroll
            for (int i = 0; i < TM; i ++) {
                A_reg[i] = As[threadRowBase + i][localK];
            }

            #pragma unroll
            for (int j = 0; j < TN; j ++) {
                B_reg[j] = Bs[localK][threadColBase + j];
            }

            #pragma unroll
            for (int i = 0; i < TM; i ++) {
                #pragma unroll
                for (int j = 0; j < TN; j ++) {
                    accum[i][j] += A_reg[i] * B_reg[j];
                }
            }
        }

        __syncthreads();
    }

    #pragma unroll
    for (int i = 0; i < TM; i ++) {
        #pragma unroll
        for (int j = 0; j < TN; j ++) {
            int row = blockIdx.y * BM + threadRowBase + i;
            int col = blockIdx.x * BN + threadColBase + j;

            if (row < M && col < N) {
                int index = row * N + col;

                C[index] = static_cast<T>(
                    alpha * accum[i][j] + beta * C[index]
                );
            }
        }
    }
}


int main () {
    const int N = 1024;
    const int M = 1024;
    const int K = 512;
    float alpha = 1.3f;
    float beta = 2.1f;
    std::vector<float> h_A_matrix(M*K);
    std::vector<float> h_B_matrix(K*N);

    std::vector<float> ref_C(M*N, 1.0f);
    std::vector<float> ans_C(M*N, 1.0f);

    for (size_t i = 0; i < M; i ++) {
        for (size_t j = 0; j < K; j ++) {
            h_A_matrix[i * K + j] = static_cast<float>(i % 97) - static_cast<float>(j);
        }
    }

    for (size_t i = 0; i < K; i ++) {
        for (size_t j = 0; j < N; j ++) {
            h_B_matrix[i * N + j] = static_cast<float>(i % 53) - static_cast<float>(j);
        }
    }

    for (size_t i = 0; i < M; i ++) {
        for (size_t j = 0; j < N; j ++){
            float sum = 0.0f;
            for (size_t k = 0; k < K; k++)
            {
                sum += h_A_matrix[i*K+k] * h_B_matrix[k*N+j];
            }
            ref_C[i*N+j] = alpha * sum + beta * ref_C[i*N+j];
        }
    }

    float *d_A_matrix = nullptr;
    float *d_B_matrix = nullptr;
    float *d_C = nullptr;
    CUDA_CHECK(cudaMalloc(&d_A_matrix, static_cast<size_t>(M * K * sizeof(float))));
    CUDA_CHECK(cudaMalloc(&d_B_matrix, static_cast<size_t>(K * N * sizeof(float))));
    CUDA_CHECK(cudaMalloc(&d_C, static_cast<size_t>(M * N * sizeof(float))));

    CUDA_CHECK(cudaMemcpy(d_A_matrix, h_A_matrix.data(), static_cast<size_t>(M * K * sizeof(float)), cudaMemcpyHostToDevice));
    CUDA_CHECK(cudaMemcpy(d_B_matrix, h_B_matrix.data(), static_cast<size_t>(K * N * sizeof(float)), cudaMemcpyHostToDevice));
    CUDA_CHECK(cudaMemcpy(d_C, ans_C.data(), static_cast<size_t>(M * N * sizeof(float)), cudaMemcpyHostToDevice));

    dim3 block(NUM_THREADS);
    unsigned grid_size_x = (N + BN - 1) / BN;
    unsigned grid_size_y = (M + BM - 1) / BM;
    dim3 grid(grid_size_x, grid_size_y);

    gemm_warptiling<float><<<grid, block>>> (M, N, K, alpha, d_A_matrix, d_B_matrix, beta, d_C);
    CUDA_CHECK(cudaGetLastError());
    CUDA_CHECK(cudaDeviceSynchronize());

    CUDA_CHECK(cudaMemcpy(ans_C.data(), d_C, M * N * sizeof(float), cudaMemcpyDeviceToHost));

    for (size_t i = 0; i < M; i ++) {
        for (size_t j = 0; j < N; j ++) {
            if (fabs(ref_C[i * N + j] - ans_C[i * N + j]) > 1e-3f * std::max(1.0f, fabs(ref_C[i * N + j]))) {
                std::cerr << "wrong" ;
                exit(1);
            }
        }
    }

    CUDA_CHECK(cudaFree(d_A_matrix));
    CUDA_CHECK(cudaFree(d_B_matrix));
    CUDA_CHECK(cudaFree(d_C));

    std::cout << "passed!\n\n";

    return 0;
}
这里我先将block设为一维(方便逐步理解)
int tid = threadIdx.x;      // 0..127
int warpId = tid / 32;      // 0..3
int laneId = tid % 32;      // 0..31
block tile中有2*2个warp tile, N方向的warp数量为2,映射公式:
int warpRow = warpId / WARPS_N;
int warpCol = warpId % WARPS_N;
该warp在block tile中负责的起点:
int warpRowBase = warpRow * WM;
int warpColBase = warpCol * WN;
一个warp tile中:
M 方向有 WM/TM = 4 个 thread tile
N 方向有 WN/TN = 8 个 thread tile
因此把32个lane看成4*8,我们定义:
constexpr int THREAD_TILES_N = WN / TN;  // 8

int laneRow = laneId / THREAD_TILES_N;   // 0..3
int laneCol = laneId % THREAD_TILES_N;   // 0..7

大概看图理解会更简单一点。
这一节的GEMM先告一段落,我也有点做力竭了。
下一节去从系统上对它进行优化